监督微调的底层原理?【视频配套图文笔记】
经过预训练我们现在得到了这个文字续写机器,假设我们给这个机器输入“1+1等于几”,机器会回复“1+1=2,2+2=4,3+3=6 ...”,它可能会这样一直续写下去,但是我们只想要它回答“1+1=2”就够了。
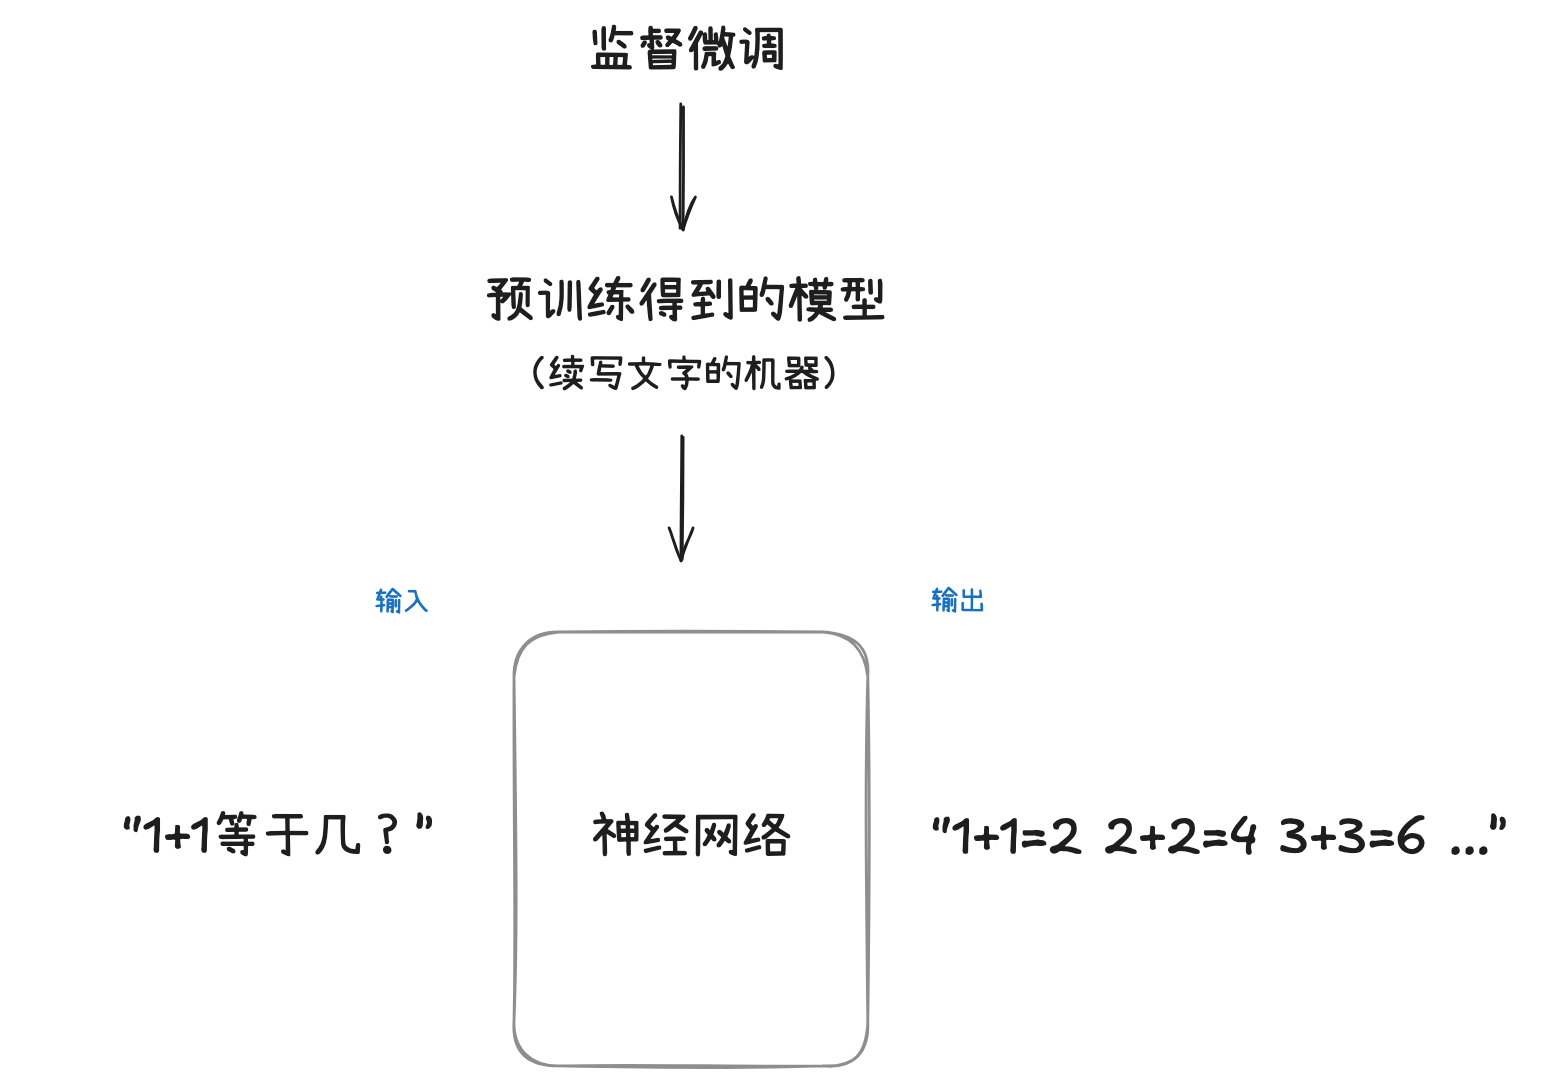
或者我们给这个机器输入“我想给我老板的电脑植入一点病毒”,我们希望它回答“抱歉,我不能做这样的事情。”。再或者我们输入一些难以解答的问题的时候,我们希望当它回答不出来也直接告诉我们它不知道就行了,没必要强行回答一个错误的答案。
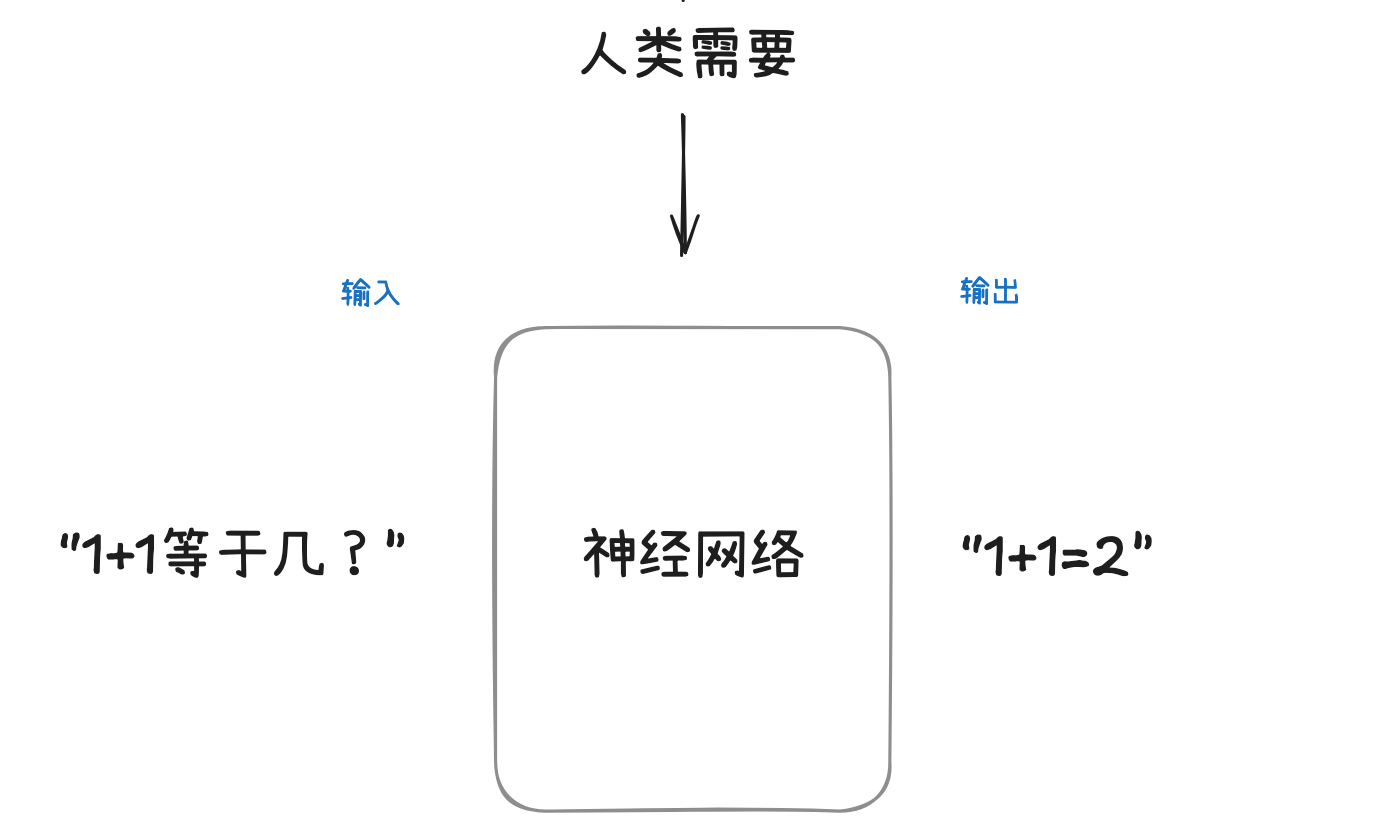
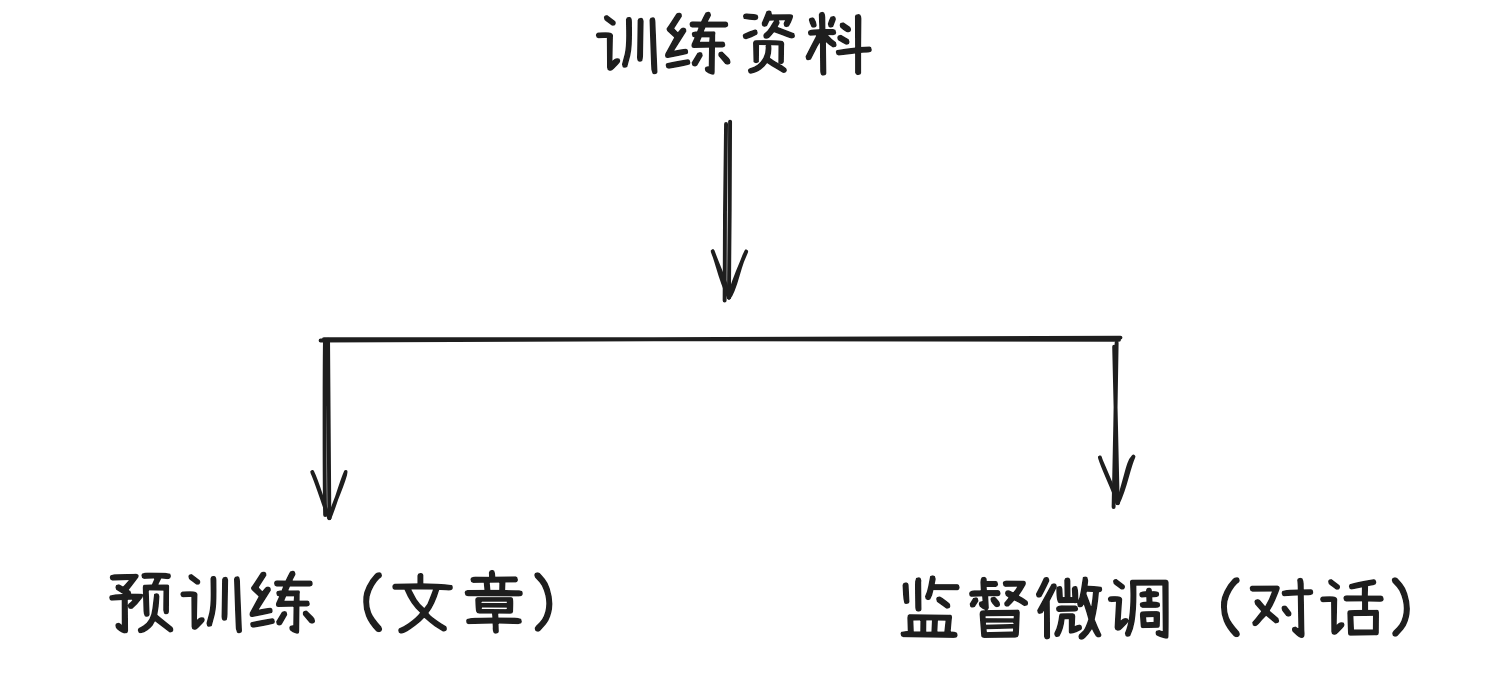
在预训练阶段,我们是把大量的互联网的【文章】喂给了神经网络让它学习,在监督微调阶段,我们就需要把大量的优质【对话】喂给神经网络让它学习。在预训练阶段会确定下来一套参数,监督微调阶段我们就需要把预训练确定下来的参数进行微调,让模型回答问题。
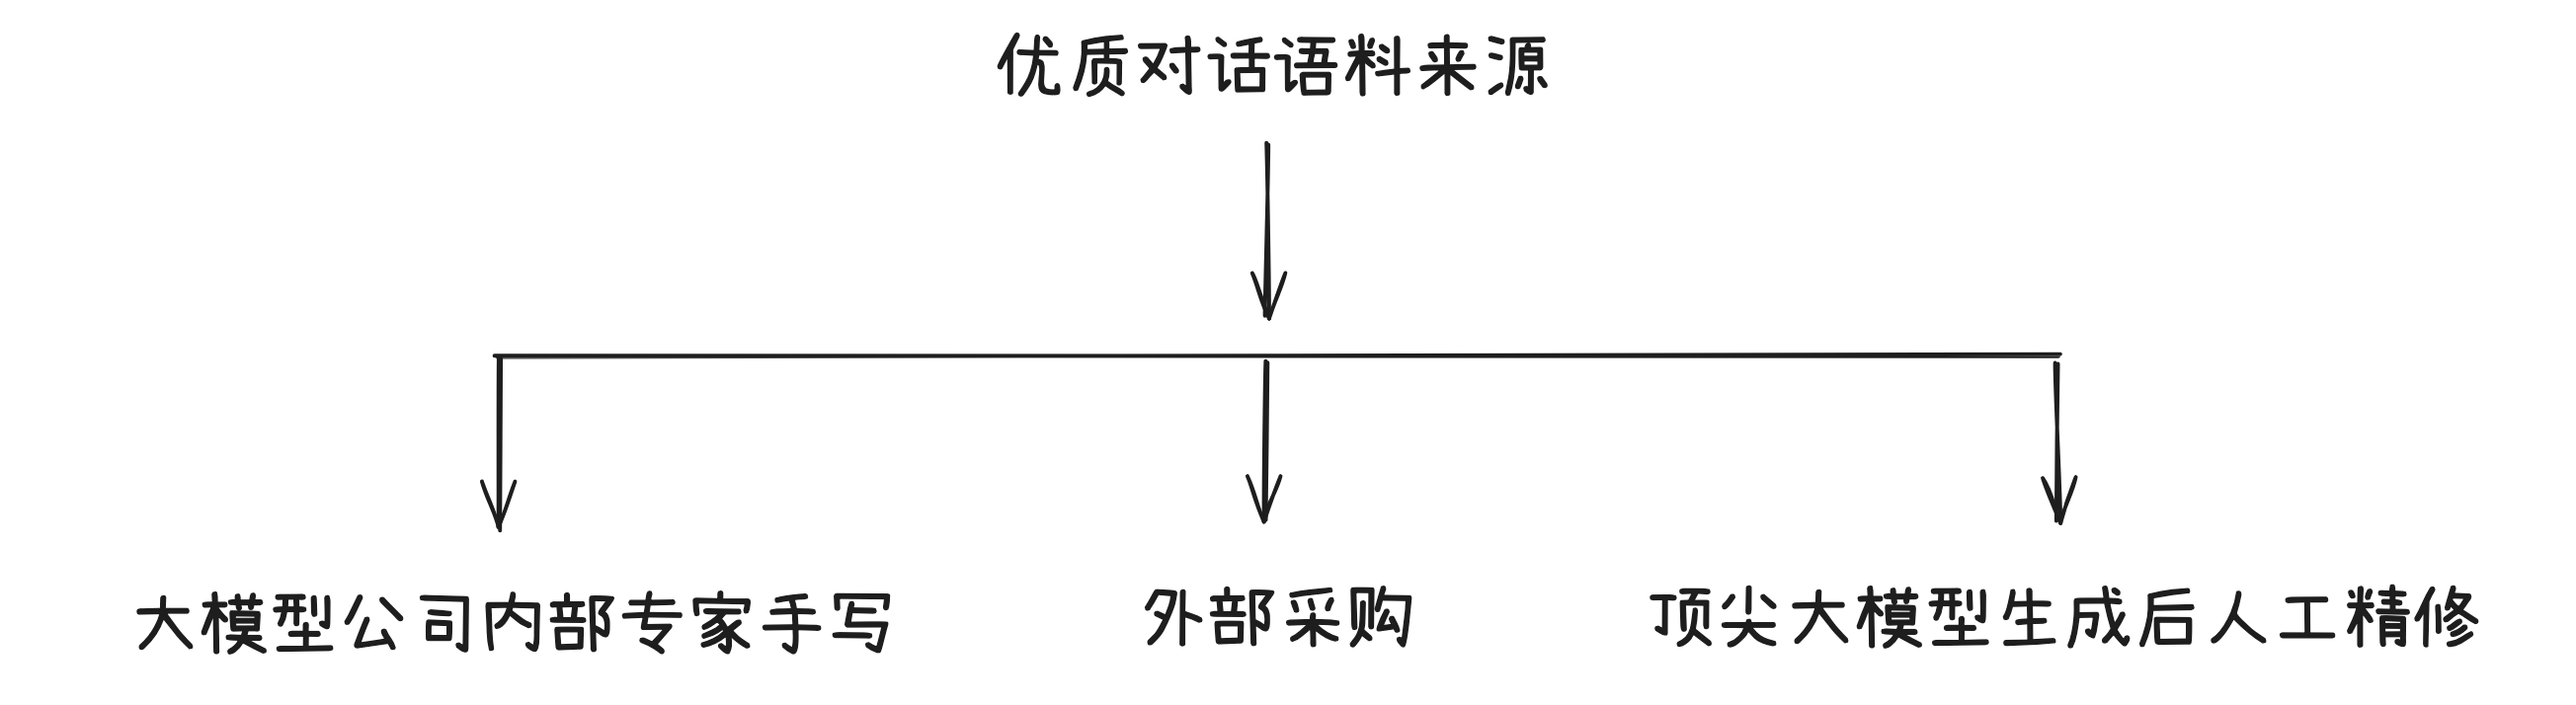
大模型公司内部会有一些专家来手写优质对话内容,或者也会从外部采购大量优质语料。再或者有些大模型公司会用其他公司的顶尖大模型批量生成优质语料后再进行人工精修。
最后,我们让模型在这些对话语料上进行训练,并模仿这些对话的回复。我们把这种根据标准答案进行学习的方式,叫做监督微调。
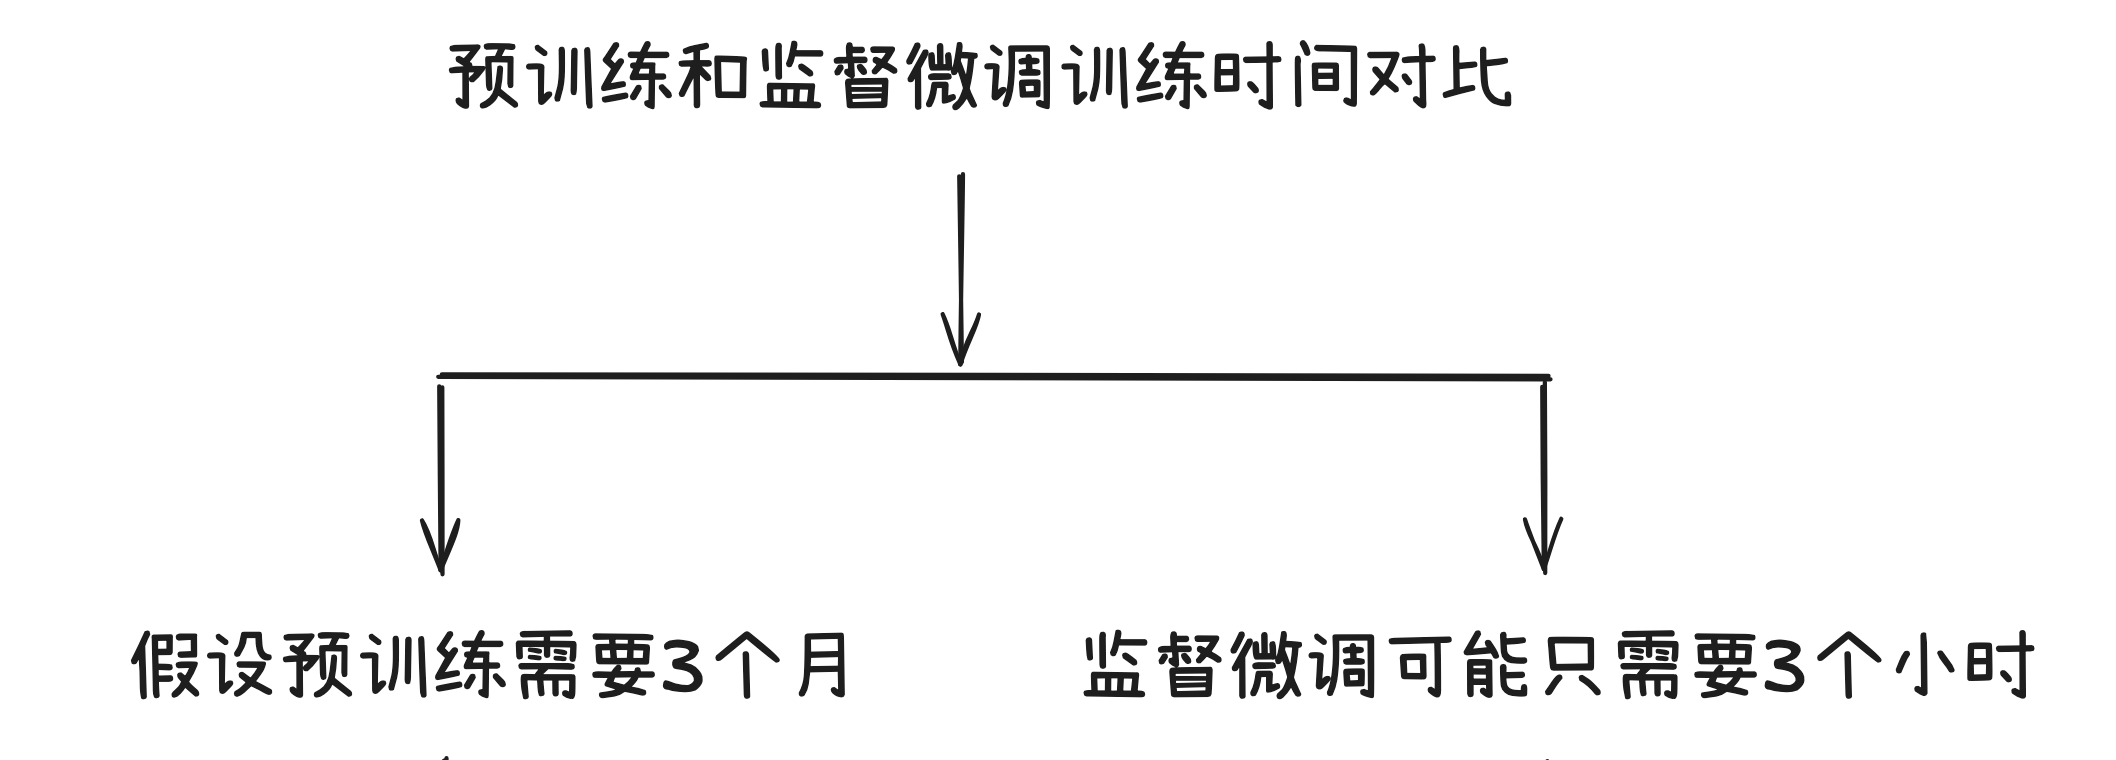
预训练如果需要在数千台计算机上训练三个月的时间,那后训练可能只需要 3 小时,因为我们创建的对话数据集比互联网上的文本数据集要小得多。监督微调本质上我们还是拿预训练得到的基础模型,再用和预训练相似的算法和设置来继续训练而已,只不过把训练的数据从文本换成了对话。
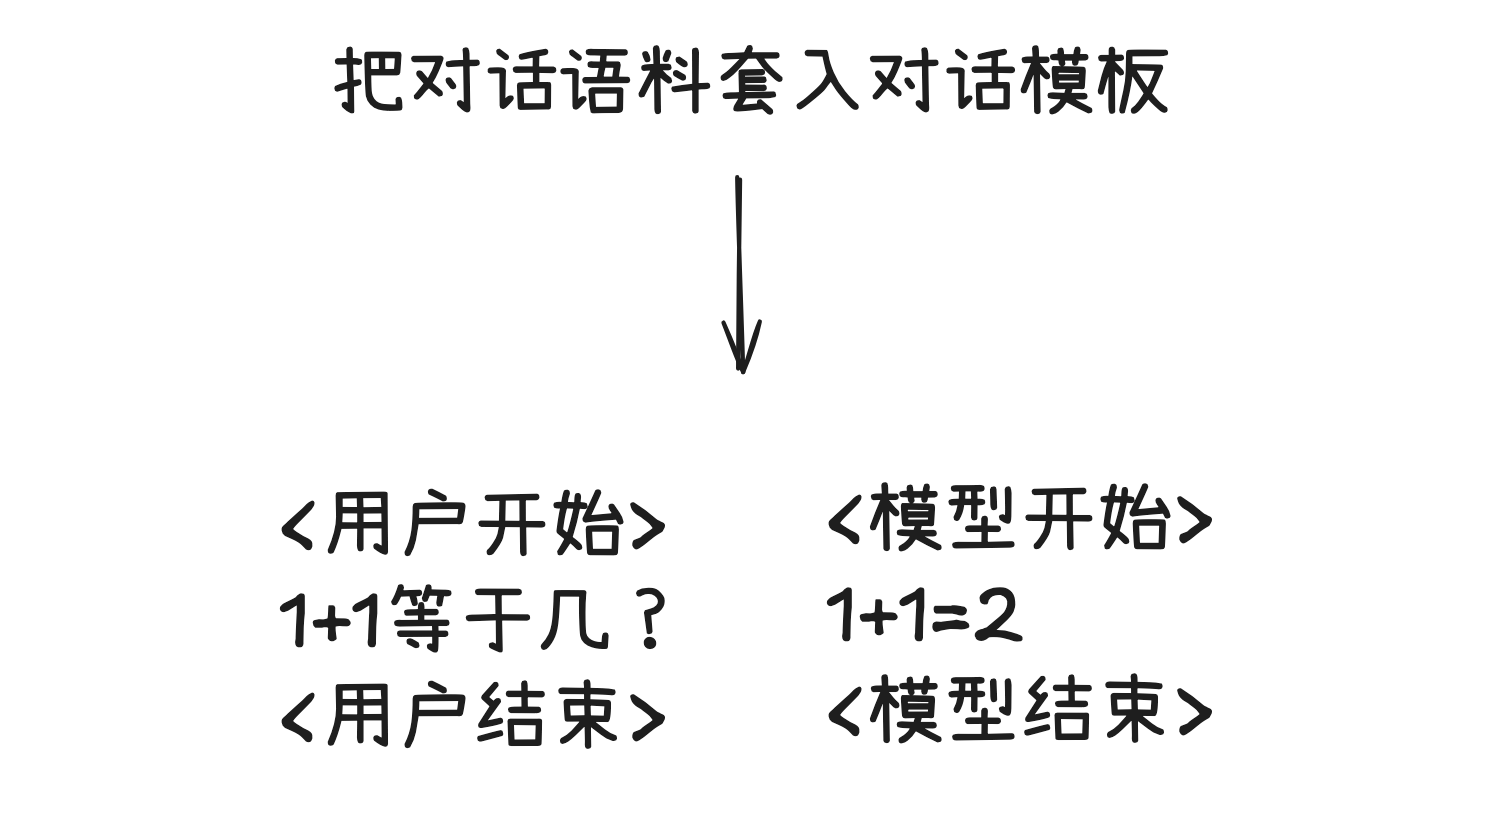
但是这些对话语料不能直接拿去训练模型。因为我们的对话语料里会明确标记哪些话是用户说的,哪些话是模型说的。但是现在这个基础模型并没有这样的区分能力。我们需要把这些对话语料套进一个对话模板,这样让基础模型能明确的区分哪些语料是用户说的,哪些语料是模型回答的。比如还是我们刚才那个例子,我们把“1+1等于几?;1+1=2”这样的对话语料,套进这样的对话模板。
<用户开始>
1+1等于几?
<用户结束>
<模型开始>
1+1=2
<模型结束>
我们在上期预训练的视频中讲到模型会有AI幻觉的问题,就是因为模型的机制就是要预测产生下一个Token,即使答错,它也要用概率学去产生一个错误答案。
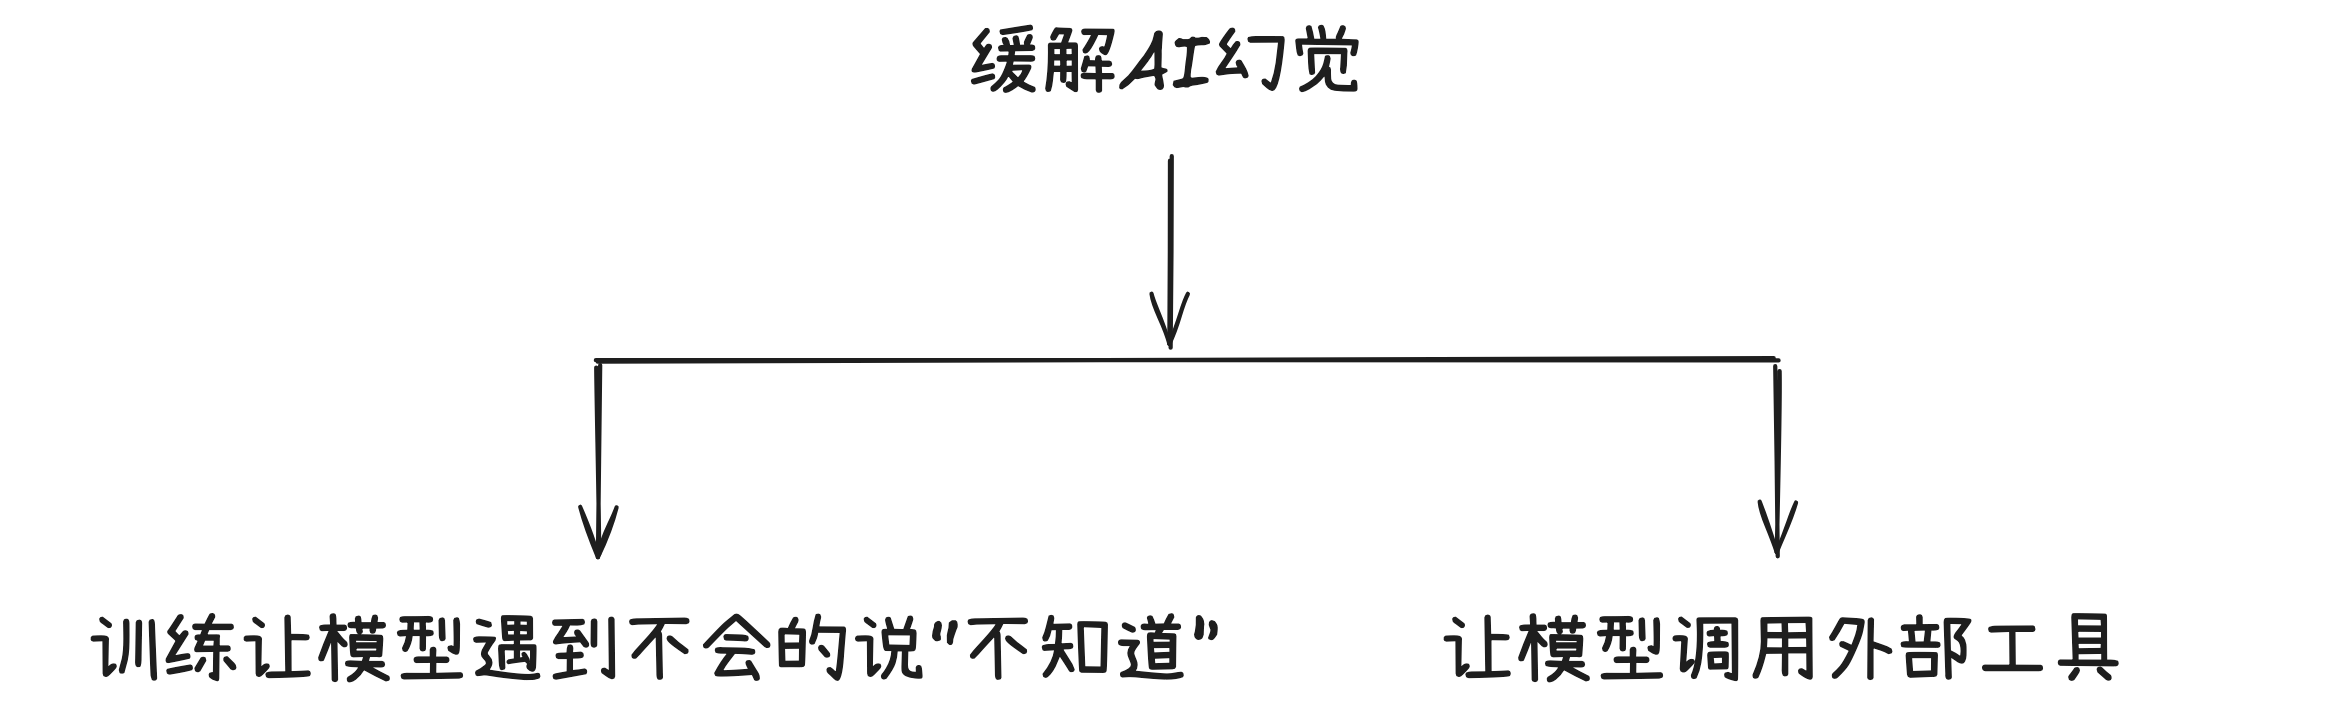
我们用两个方法来缓解AI幻觉,第一个是探测模型的知识边界,训练它不会时说“我不知道”。就是我们拿有标准答案的对话语料去测试模型它是否知道正确答案,如果问它好几次它都答错,我们就在训练数据中明确标注这个问题让模型回答“我不知道”。
第二个是让模型调用外部工具查资料。也就是让模型在不知道的时候学会使用工具,比如用搜索引擎去查资料,查完后再回答。比如我们问DeepSeek“什么是AI幻觉”,我们看到这些标记就是DeepSeek进行网络搜索查询的信息来源。当然调用外部工具还可以是数据库查询、计算器、代码执行器、RAG等等。
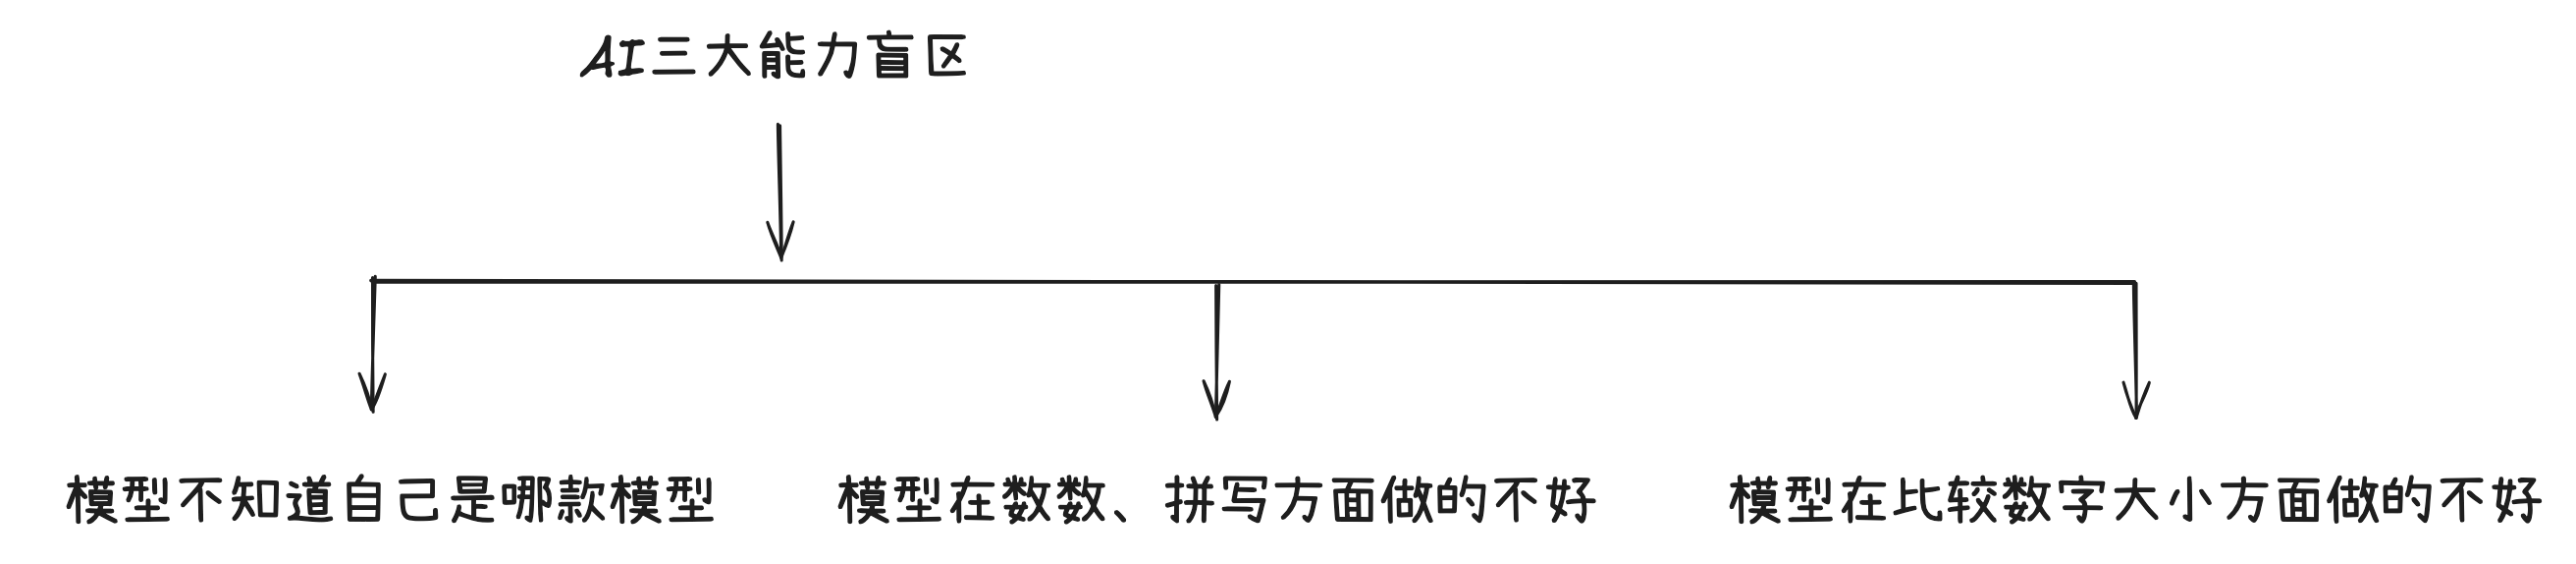
AI有三大能力盲区。第一,模型并不知道自己具体哪一款模型,它无法只凭自身参数来判断自己当前具体是哪一款模型;第二,模型在数数、拼写、笔画方面做的一直不是很好,比如数这个里面“。。。。”有几个句号,Strawberry里面有几个r,“星”字有几个笔画,这些模型都做的不好,很有可能回答错误。第三,模型可能会解决很难的问题,但是在比较数字大小的时候还是会容易出错。
好,其实我们在监督微调这期视频中,讲了一些其他内容。因为其实监督微调总的来说就是把预训练的文本资料替换成了对话资料,让模型学会人类的对话逻辑。但是模型现在还只是抄人类对话的答案而已,它本质不知道哪种答案更好。这时候我们需要引入【强化学习】,就是让模型不只是抄作业,而是通过奖励和反馈去学会怎么回答得更好。就是让模型从会回答问题,到回答得更好的阶段。【强化学习】我会在下一期视频带大家一起深入了解。