回顾预训练➕监督微调
前两期视频我分享了预训练和SFT监督微调的学习笔记,经过预训练我们得到了一个文字续写机器,但是我们要的是一个能解决我们实际问题的智能助手。
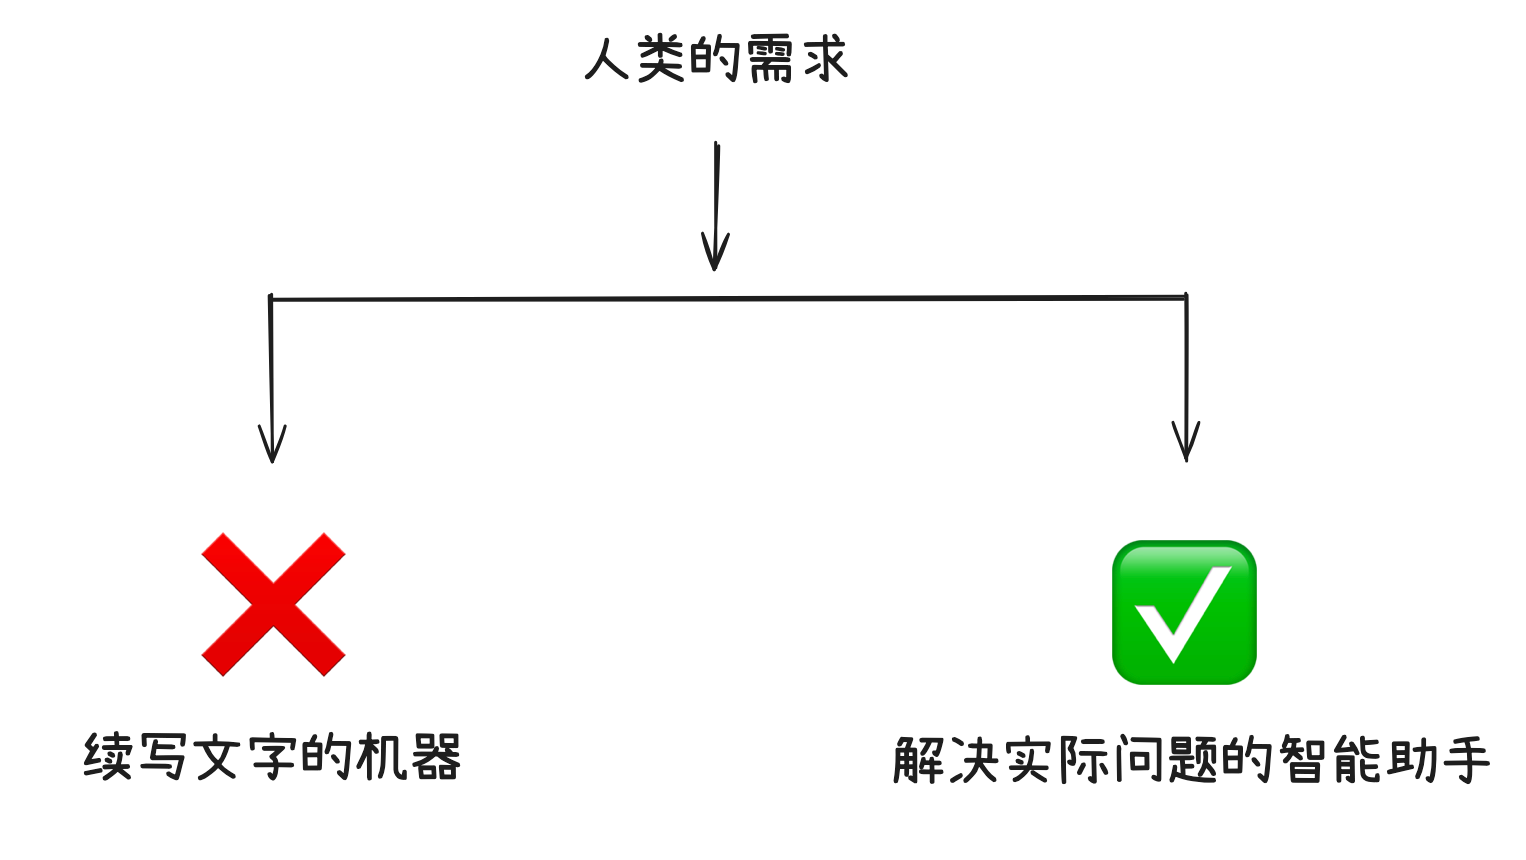
所以又通过SFT监督微调得到了一个会模仿人类对话进行回复的机器。
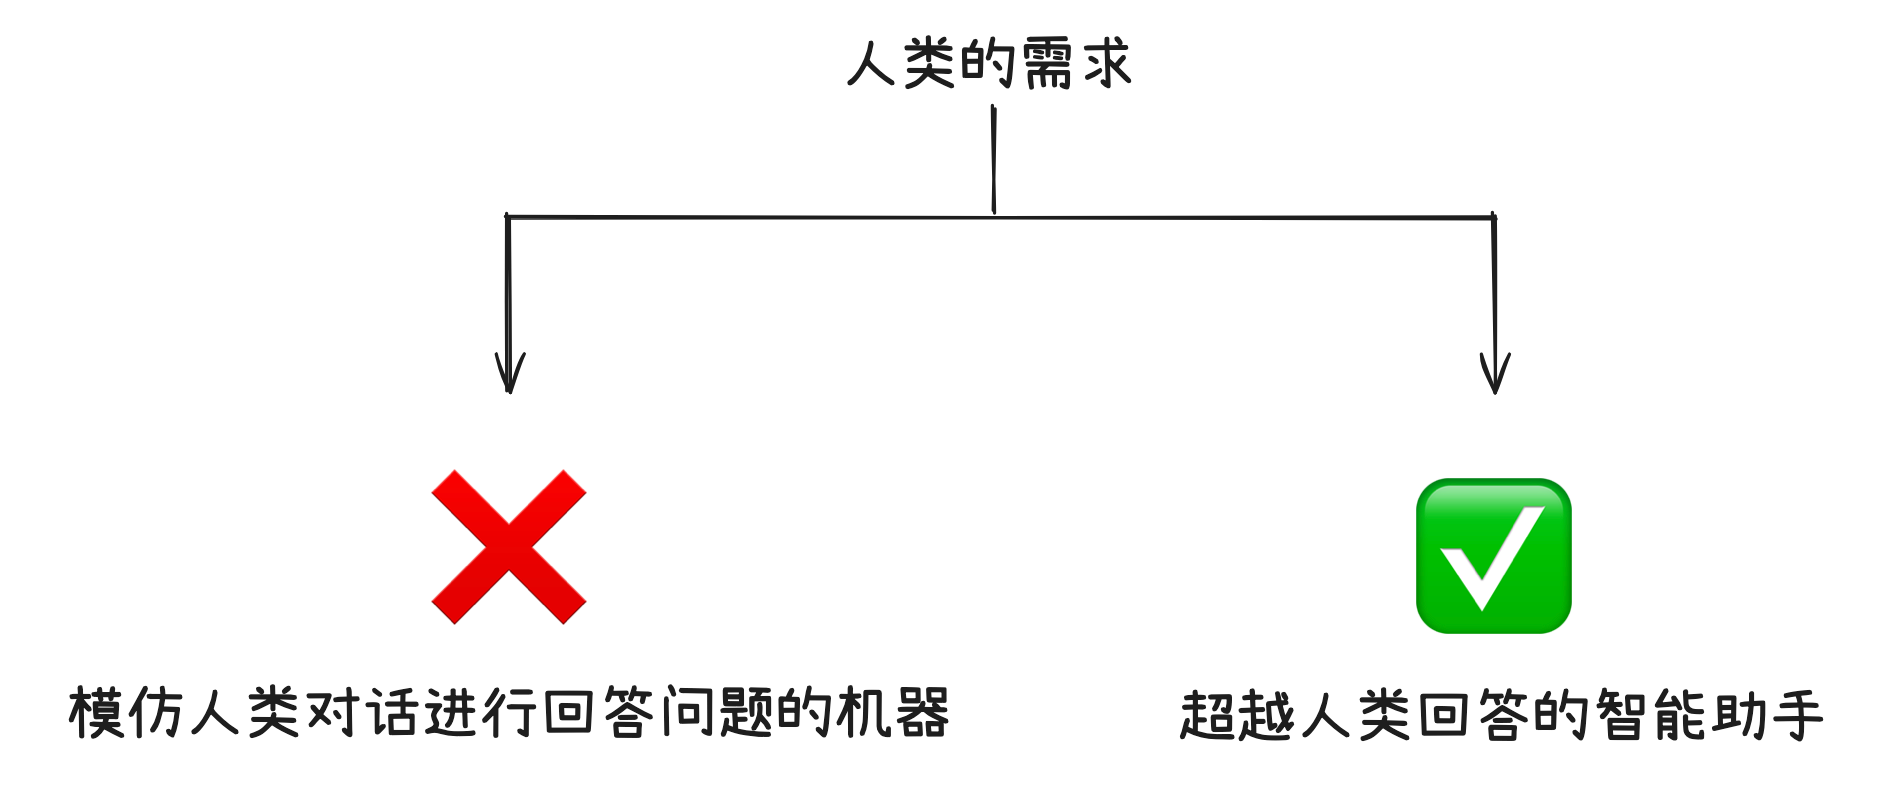
但是我们不想只是让模型抄人类的对话答案,我们希望模型能回答的比人类更好。这时候我们就要引入强化学习(RL)了。
强化学习(可验证领域)
首先,数学书里面的内容结构我们还熟悉吗?一般都是先有一些概念解释的文字说明,然后会有一些例题,最后每个小节会有几个练习题。我们就可以大致把数学书里的内容分为这三大类。第一类概念解释相当于我们的预训练阶段,给模型喂一些文字知识去学习;第二类例题相当于我们的监督微调,让模型学习问题、解题过程和答案;第三类练习题相当于强化学习,练习题一般在书的最后几页会有答案,但是没有解题过程。模型通过问题和答案自己去找解题过程。
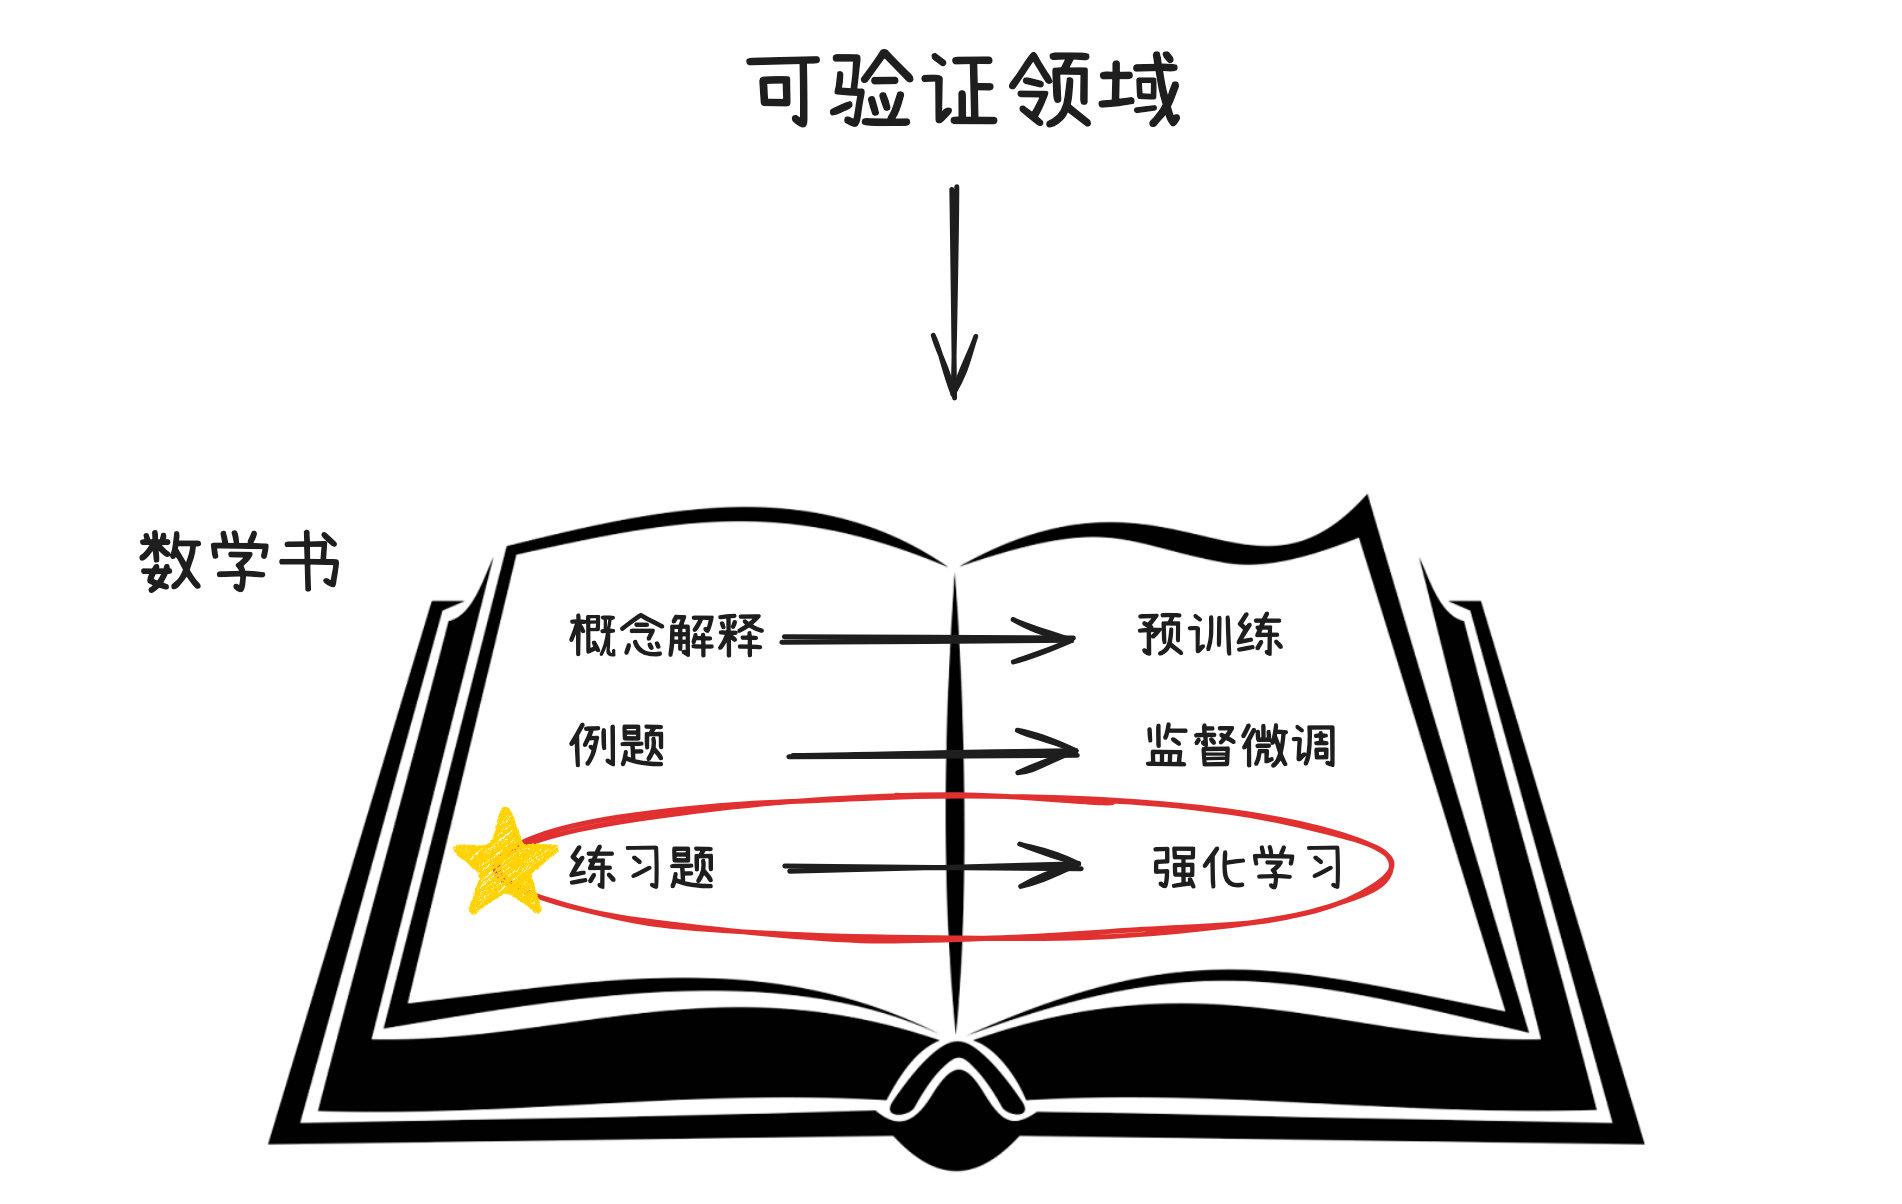
其实练习题是非常重要的,他能检验你是否熟练掌握某一个知识点,或者是否能根据某一个知识点举一反三。所以解练习题的过程会锻炼我们去尝试用不同的方法来得到最终答案,这个解题的过程对我们学习的帮助是非常大的。
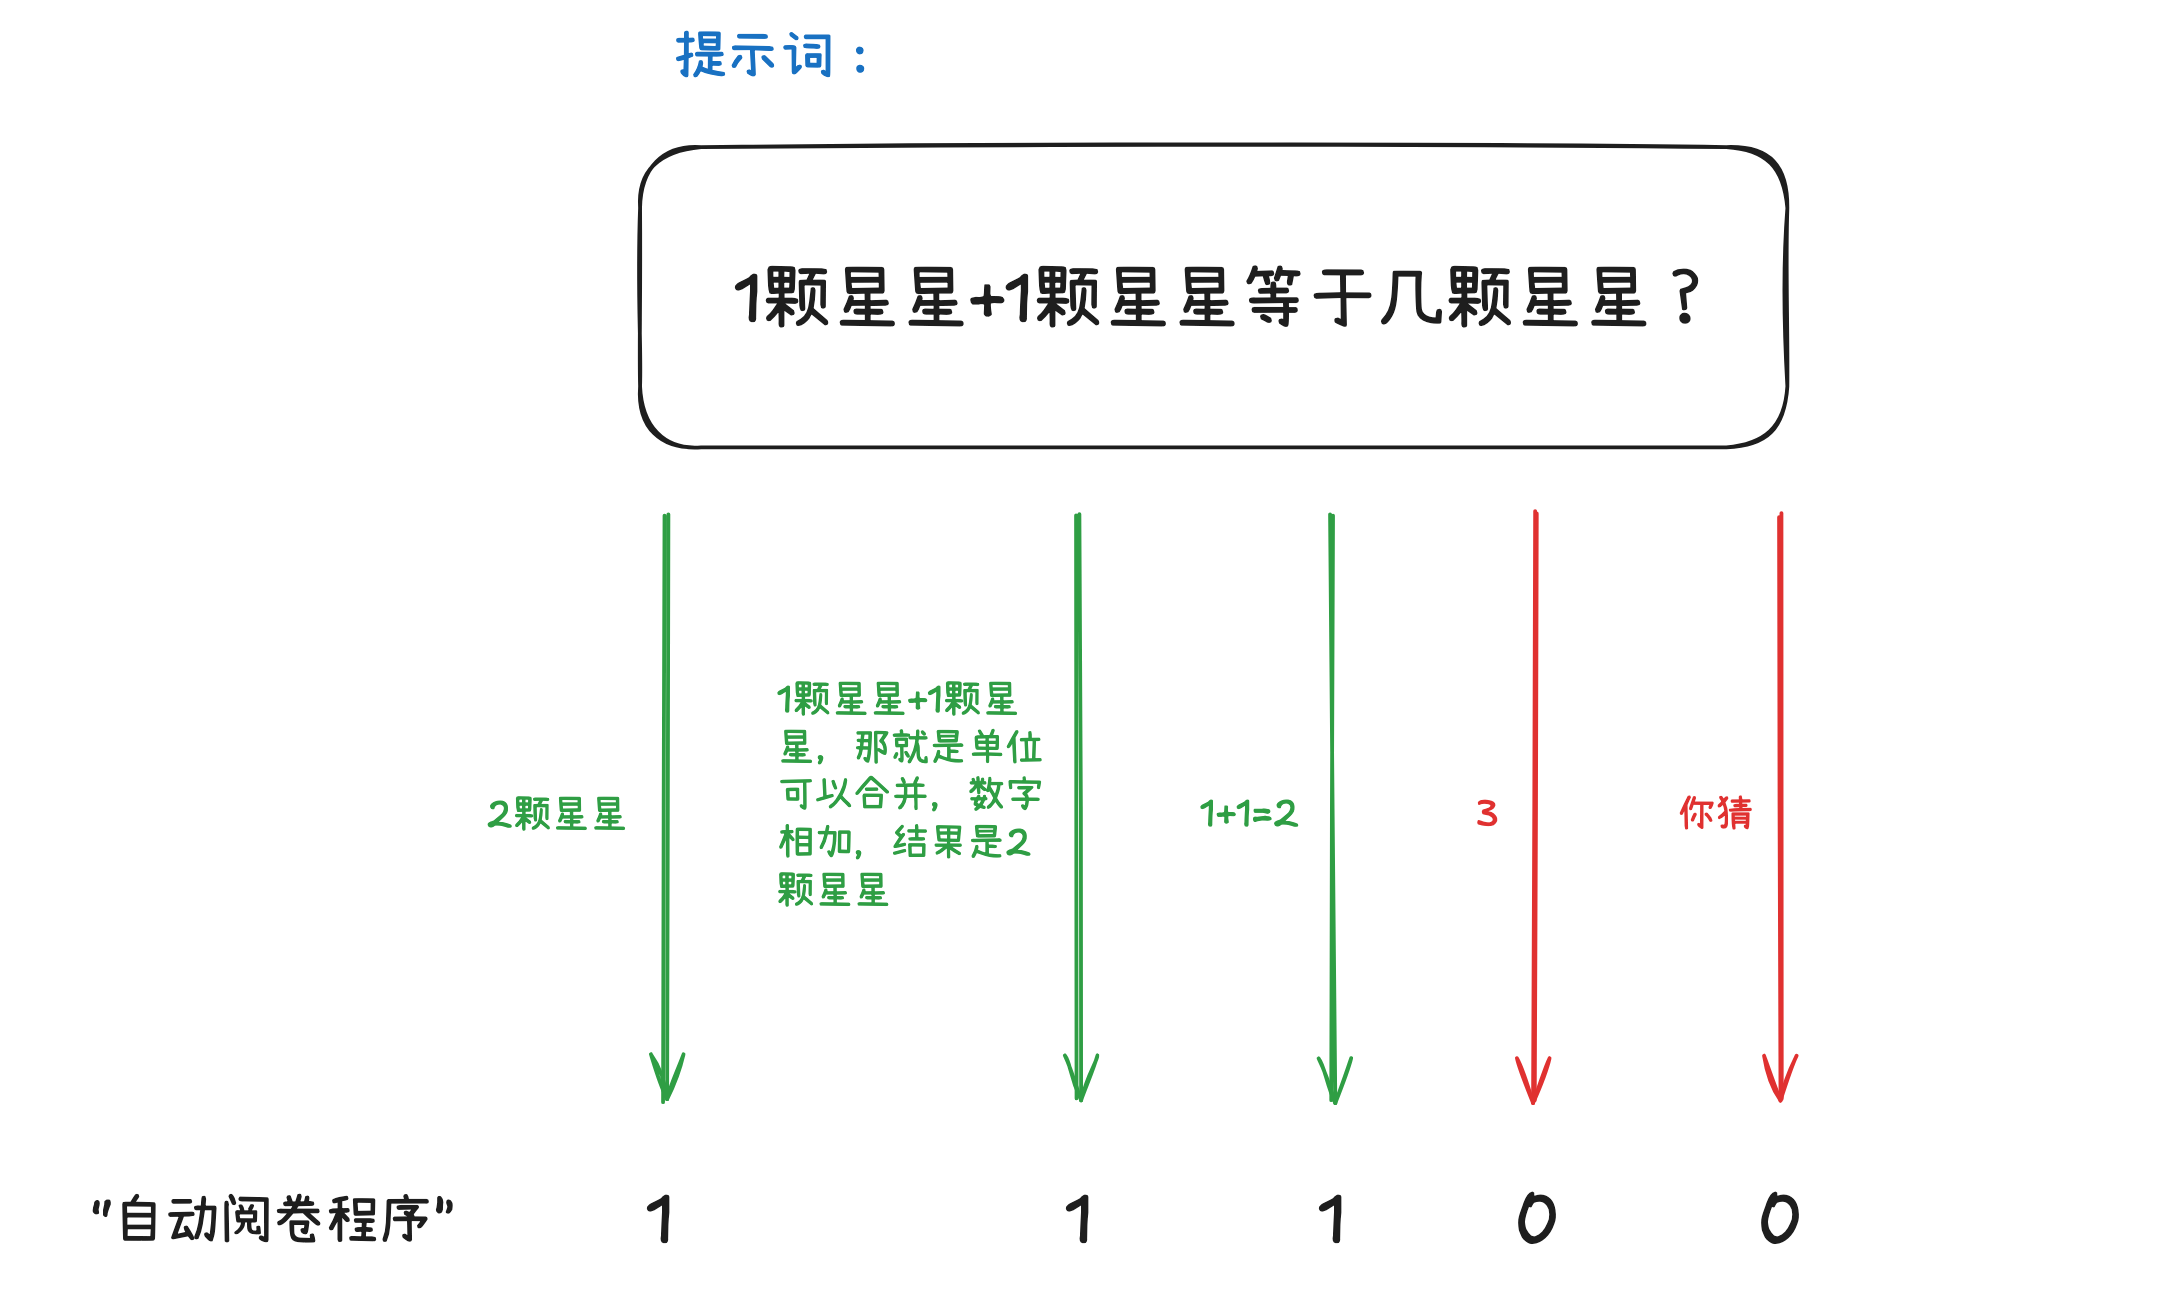
我们来举个例子解释下什么是强化学习,比如我们问经过监督微调训练后的模型,1颗星星+1颗星星等于几颗星星?它回答:
第一个答案:2颗星星
第二个答案:1颗星星+1颗星星,那就是单位可以合并,数字相加,结果是2颗星星
第三个答案:1+1=2
第四个答案:3
第五个答案:你猜
其中前三个都是正确的,后两个是错误的。这时候,我们就可以用一个“自动阅卷程序”来判断模型的答案,并给它不同的奖励。我们给前三个答案都各奖励1分,后两个就得0分。现实中的训练规模要大得多,我们会给模型输入海量的问题,让它生成海量的答案,再通过这样的程序批量判断。拿到分数之后,模型就会调整它的参数,然后再次生成答案,然后再获得新的奖励,然后再去调整模型的参数。模型就这样不断地尝试、获得反馈,再根据反馈调整自己。这就是强化学习最核心的思路。
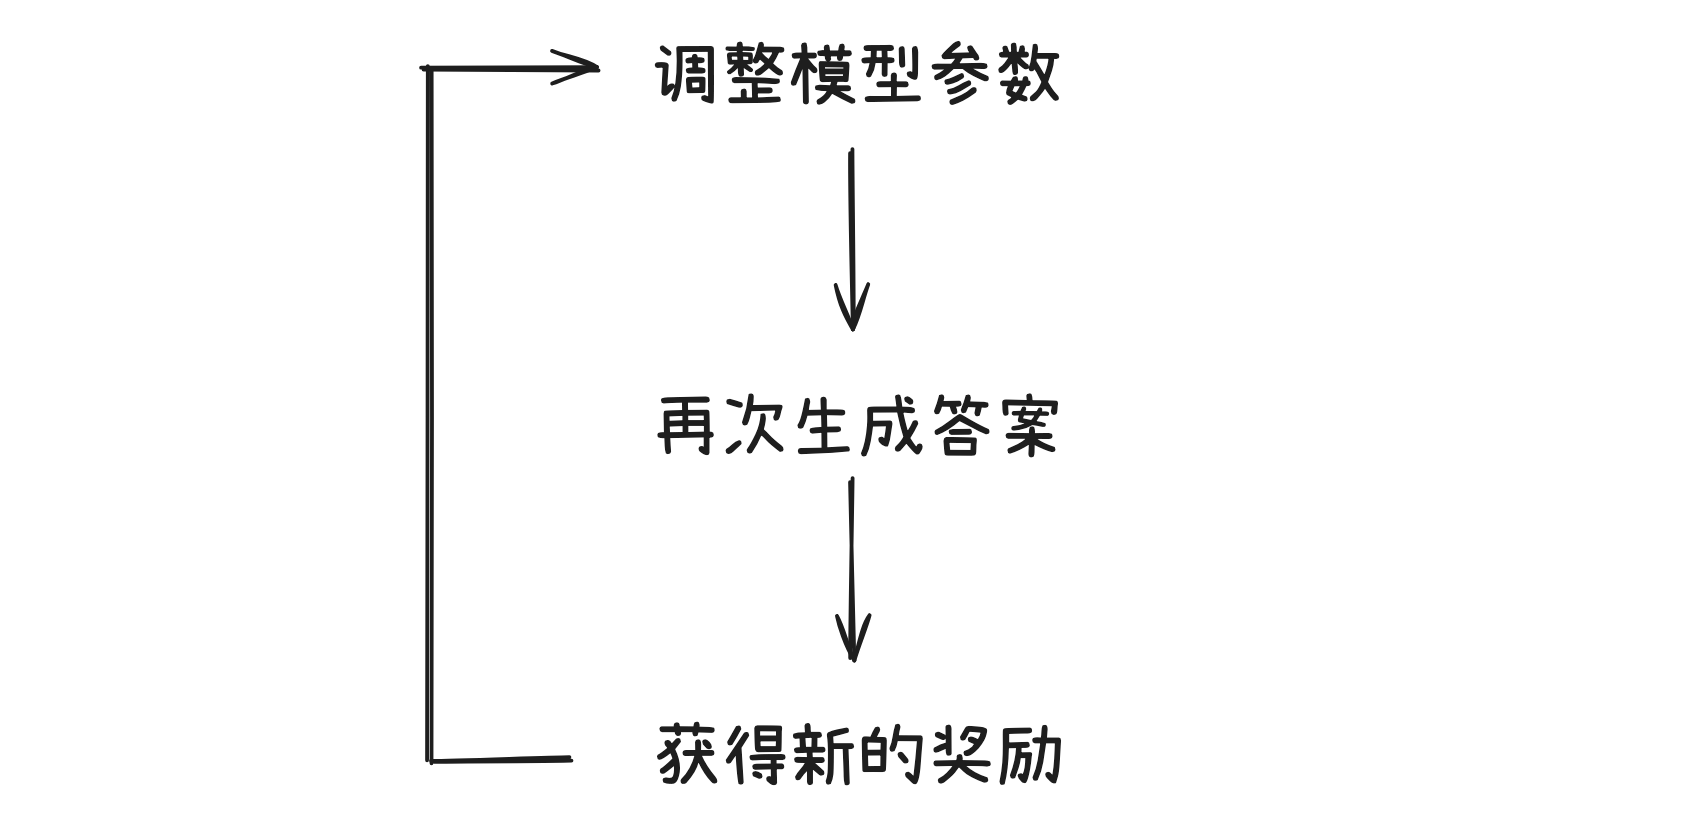
训练大语言模型就特别像我们训练或者教育小孩,只不过训练大语言模型是把这整本书的概念文字先全部看完学习完,然后再学习完整本书的例题,最后再学习完整本书的练习题。教育小孩则是一个章节一个章节的学。
像数学、代码这类有明确答案的可验证的理科领域问题,我们可以直接写一个自动阅卷程序,判断模型的答案对不对,然后把这个结果转化成奖励。
强化学习(不可验证领域)
那我们经常说,文无第一武无第二,像遇到不可验证的文科领域大模型该怎么办?
比如让大模型讲个笑话,写一首诗或者写一篇文章,我们发现大模型写的并没有像我们期待的那么好,反而我们觉得会有很大的AI味儿。那这就要涉及到这个概念了,基于人类反馈的强化学习(RLHF)。大模型不知道哪个笑话是好笑的,但是我们人类知道。大模型先输出笑话,我们人类给大模型的笑话进行打分。但是这个工作量可能是巨大的,大模型会生成海量的笑话,人类打分员不够用了,成本也非常高。这时候我们需要再训练一个打分小模型,这个打分小模型就是人类偏好模拟器,我也可以叫它“奖励模型”。注意,这个打分小模型是一个独立的模型,最后我们用这个打分小模型去给大模型的笑话打分。
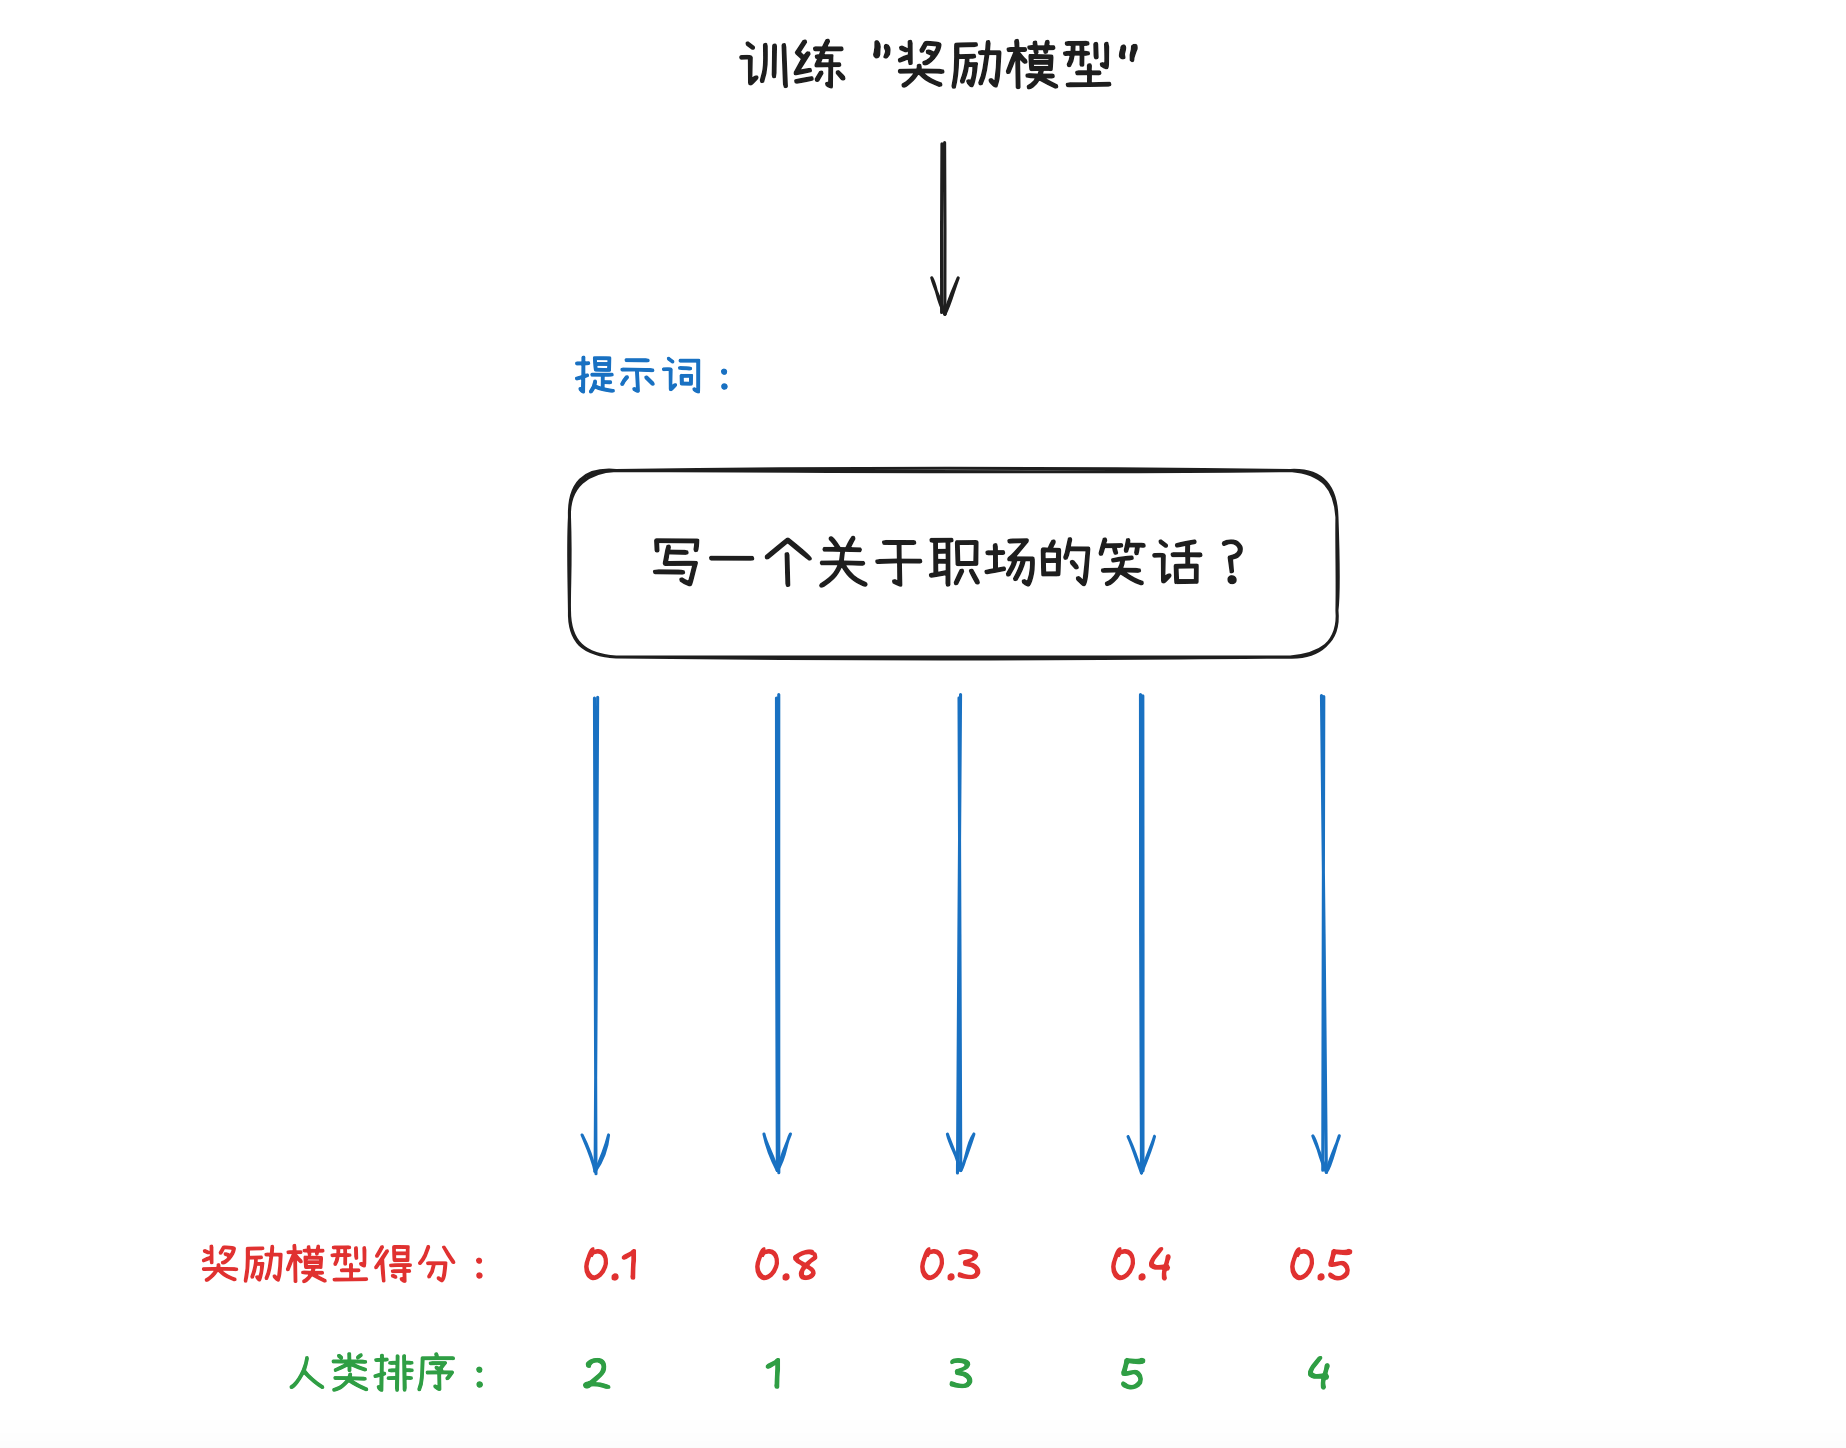
训练奖励模型的过程我们可以看这张图,我们给奖励模型输入让他它讲一个笑话,奖励模型给出了分数,人类也给出了笑话搞笑程度的排序。接下来我们会让奖励模型去学习人类的排序。具体做法是:把同一个笑话的多个版本,按搞笑程度排好序,然后不断调整奖励模型的参数,让它打的分和人类的排序越来越接近。排得一致的,说明它猜对了,就不用动;排得不一致的,就通过训练把它的分数往人类排序的方向拉。大致就是这样的一个过程。
奖励模型的优缺点
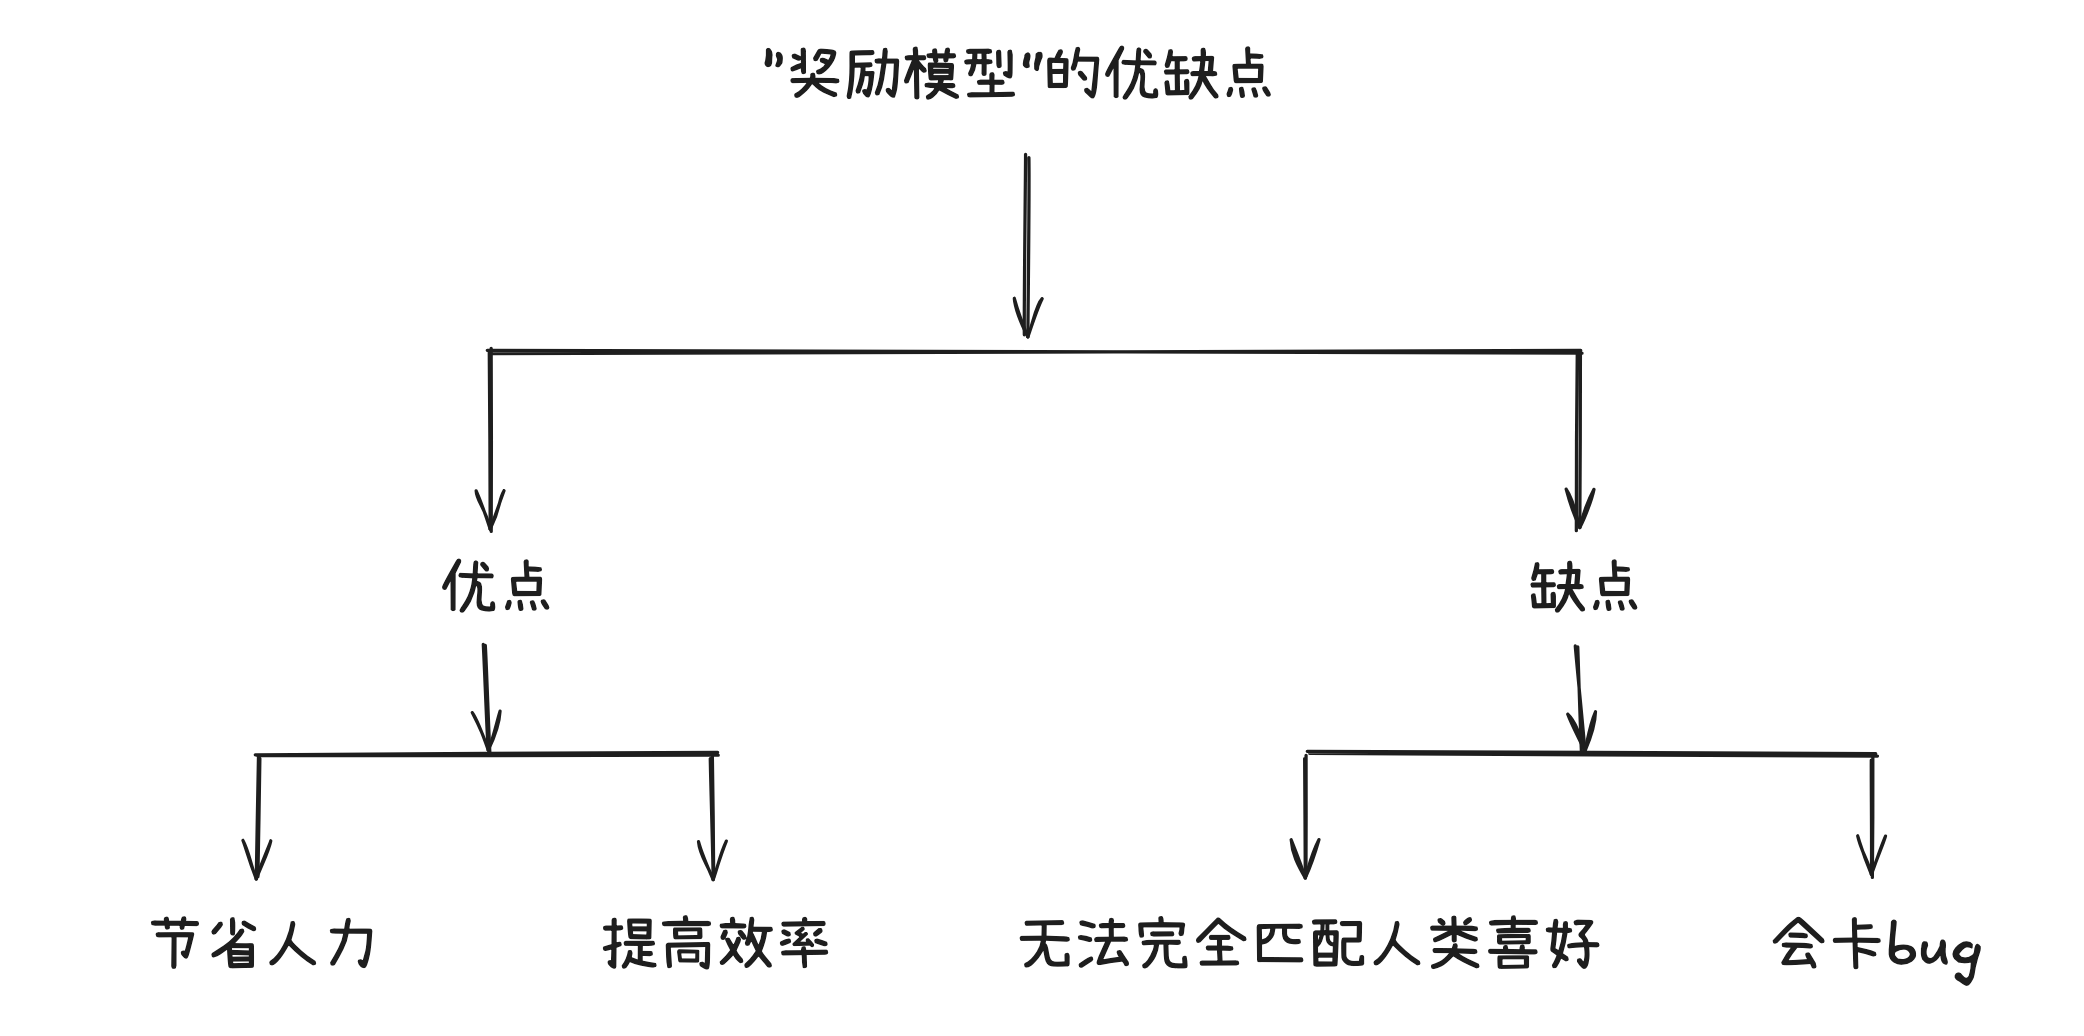
优点1:节省人力
因为人工打分的成本是非常高的。
优点2:提高效率
奖励模型打分比人类打分效率要高得很多很多
缺点1:无法完全匹配人类喜好
奖励模型本质上还是一个“人类喜好模拟器”,它并不能完全代表人类的喜好、审美,它始终是会有偏差的。
缺点2:会卡bug
因为大语言模型和奖励模型本质是还是数学函数,它俩并没有人类所谓的道德、常识。大语言模型的目的是为了从奖励模型那里得到最高分,奖励模型目的是为了匹配人类的喜好审美。它俩这样一配合,就可能出现一些极端的离谱的答案。
DeepSeek-R1
还记得 DeepSeek-R1 的论文公开后,引起了全球 AI 界的巨大轰动吗?因为这是首次有公司证明:不用人类准备好的推理数据,光靠强化学习本身,就能让模型自己练出复杂的推理能力——论文里这个叫 R1-Zero 的模型,开辟了一条全新的训练路线。而且 DeepSeek 还把完整的训练方法全部公开了,这也是我们中国公司做的。
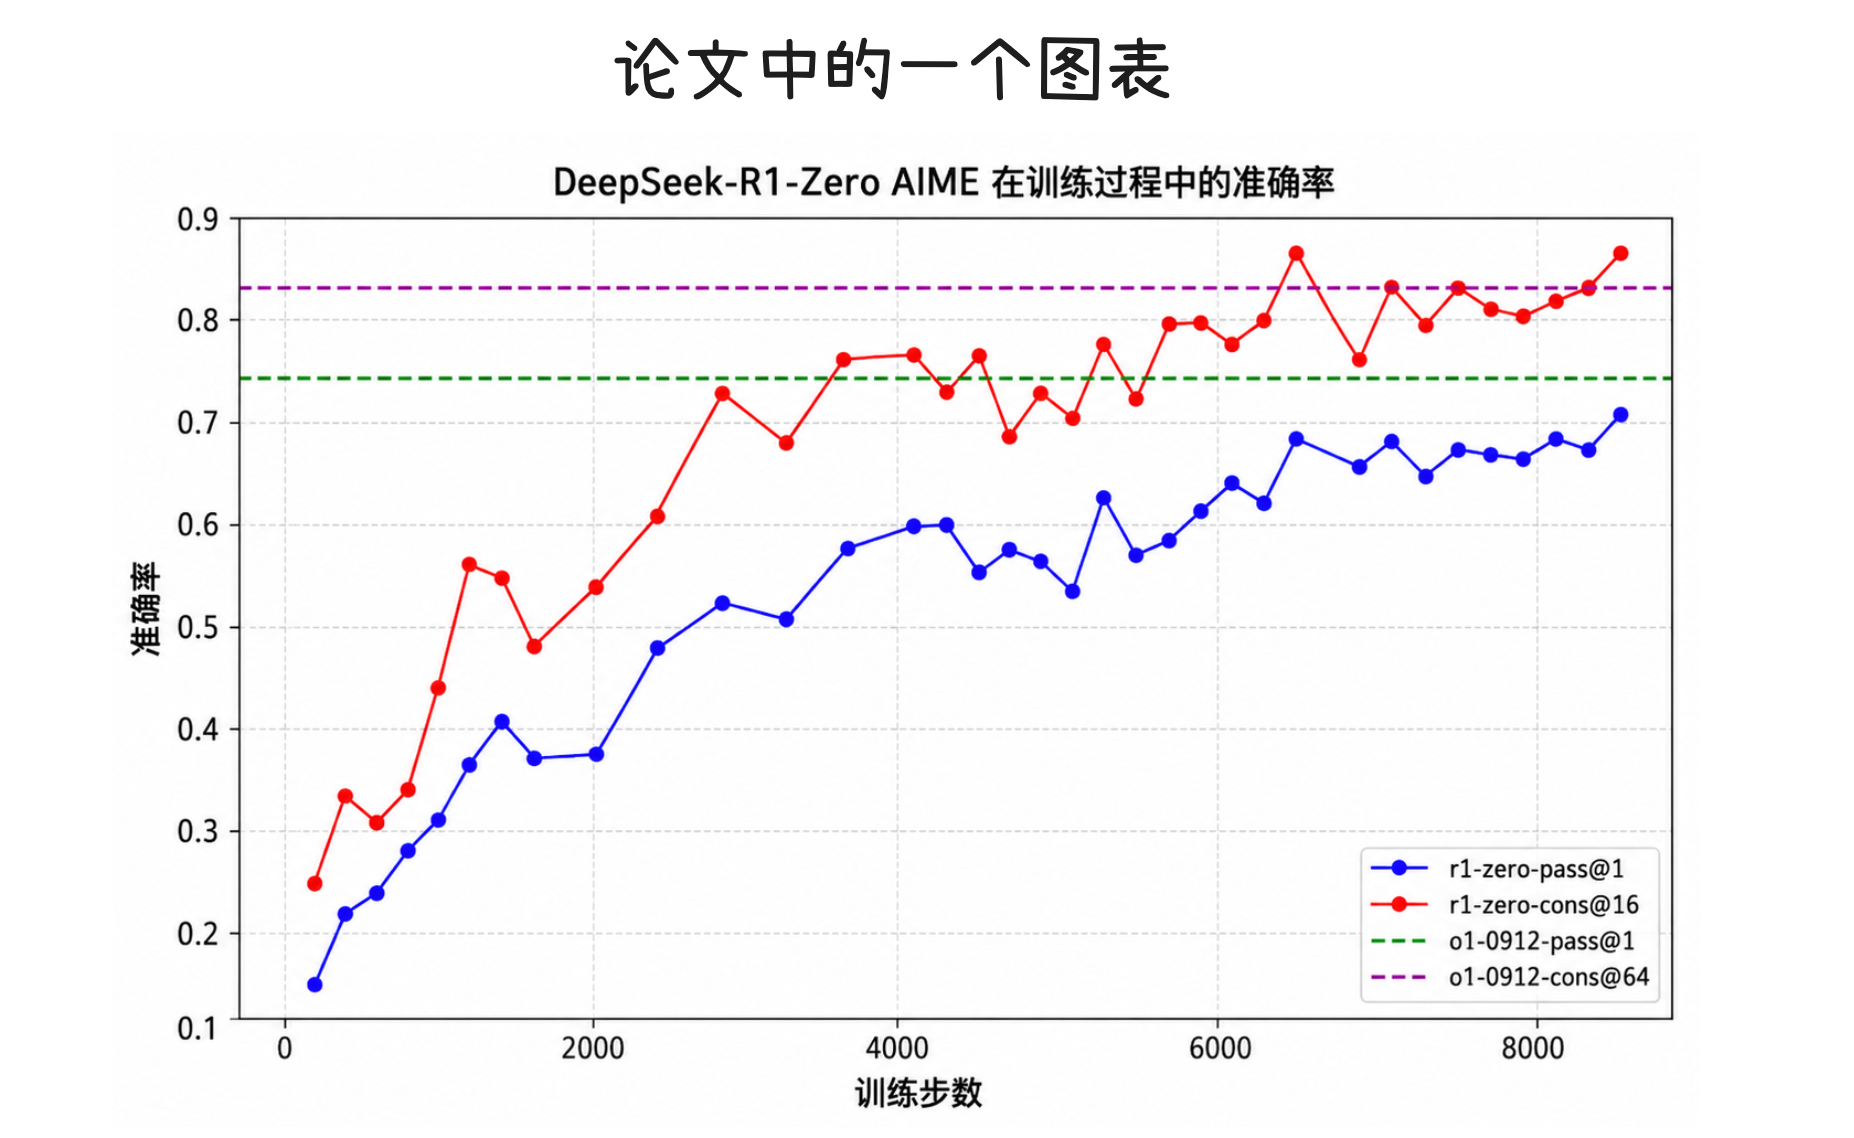
论文中有这样一个图表,表示模型解决数学问题的准确性。纵轴表示模型回答的准确性,横轴表示训练的步数。结果表明,随着步数越来越多,模型会使用更多的Token来达到更高的准确率。也就是说,模型在解决问题的过程中如果反复试错,得到的准确率会更高。我们可以说模型学会了思维链,这也导致了模型思考问题的时间变得更长了,但是解决问题的准确性也提高了。
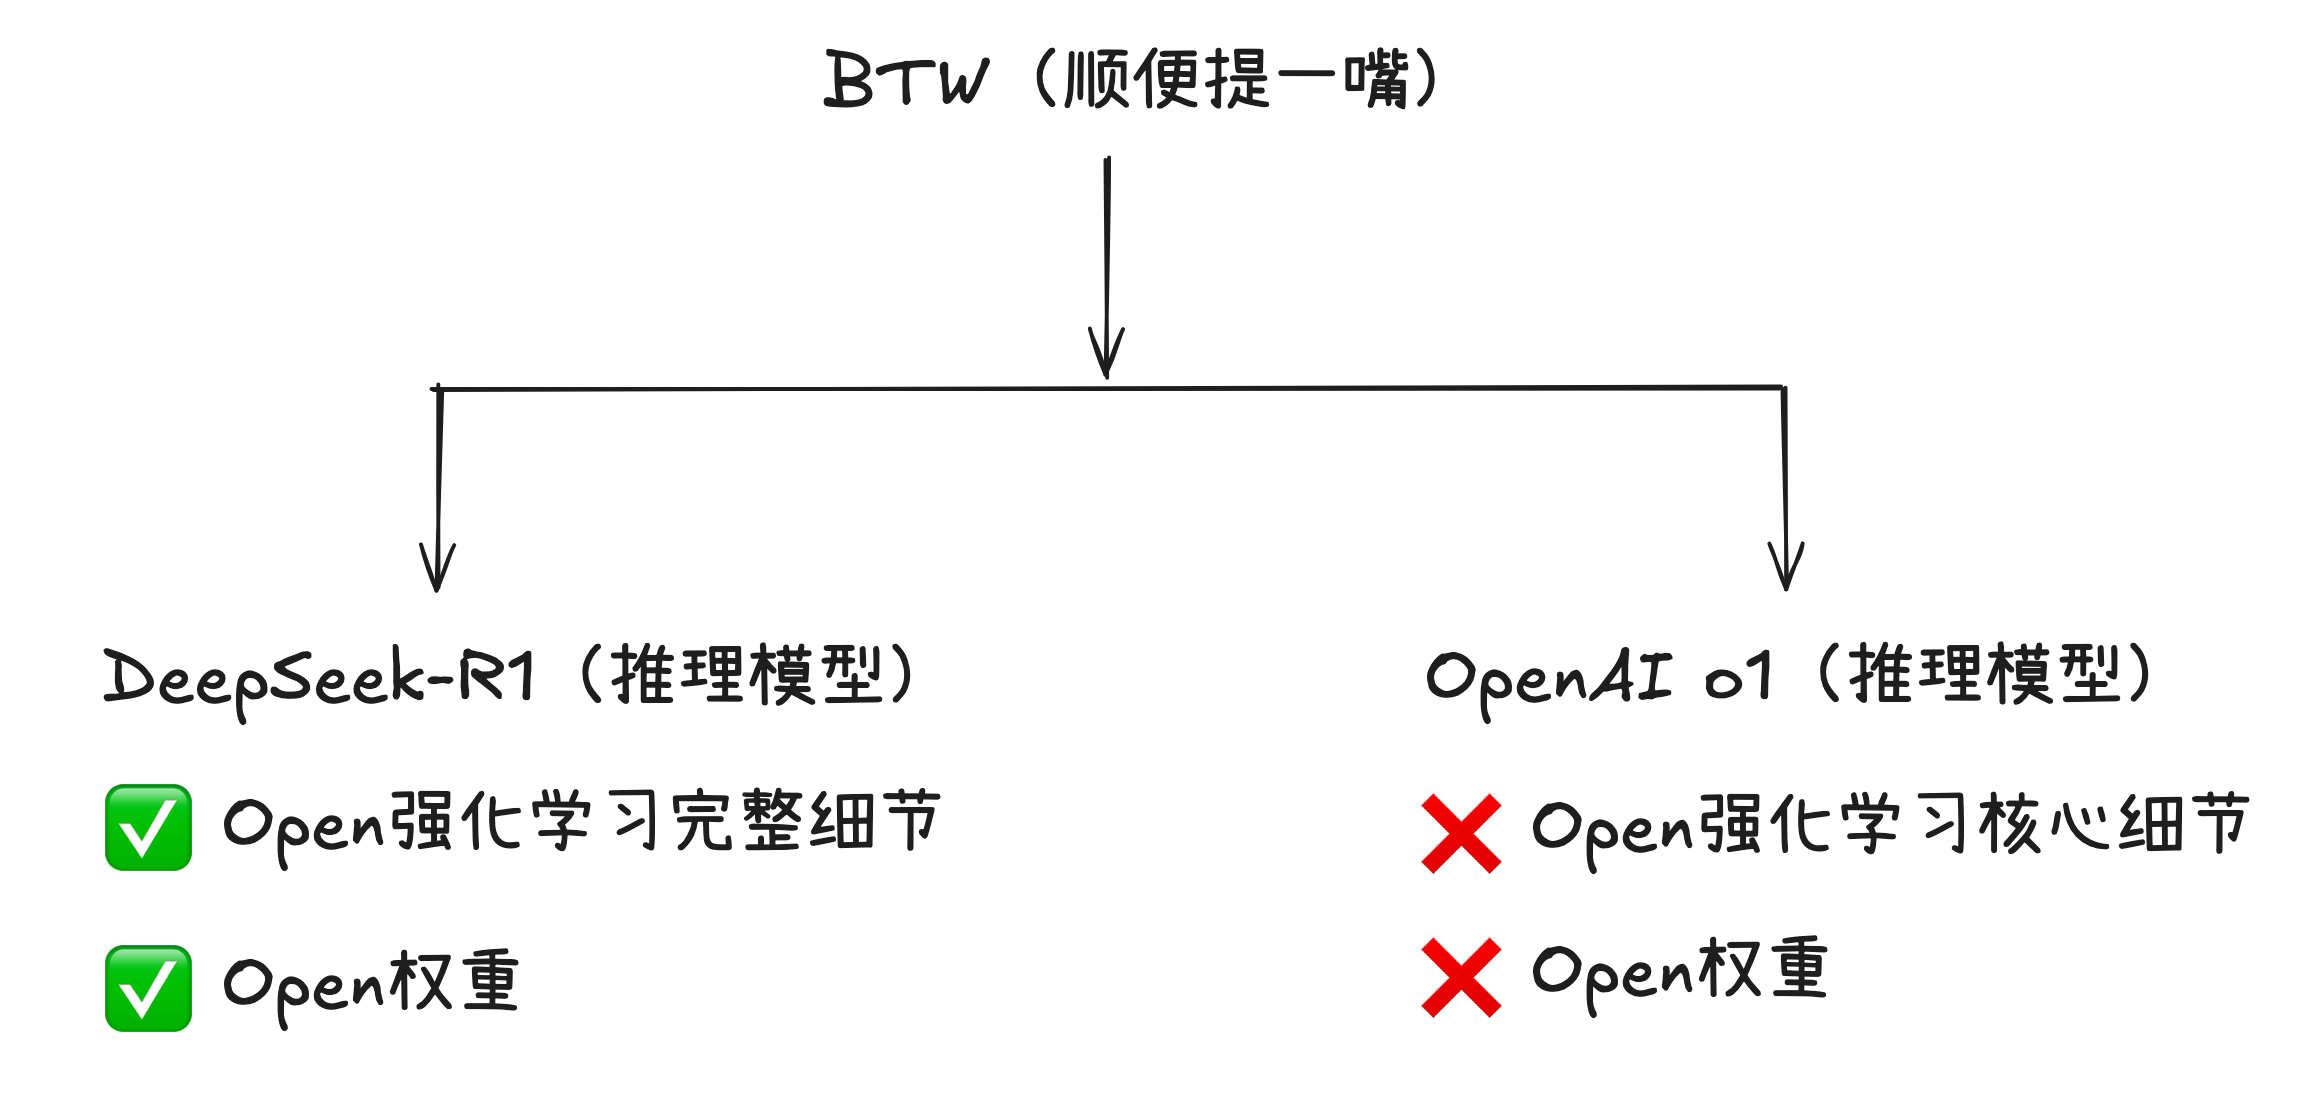
顺便提一嘴,DeepSeek-R1和OpenAI o1都是运用了强化学习的推理模型,但是OpenAI并没有Open他们强化学习的核心细节,DeepSeek则是完整的Open了。而且DeepSeek-R1 Open了权重,OpenAI o1没有Open权重。
AlphaGo
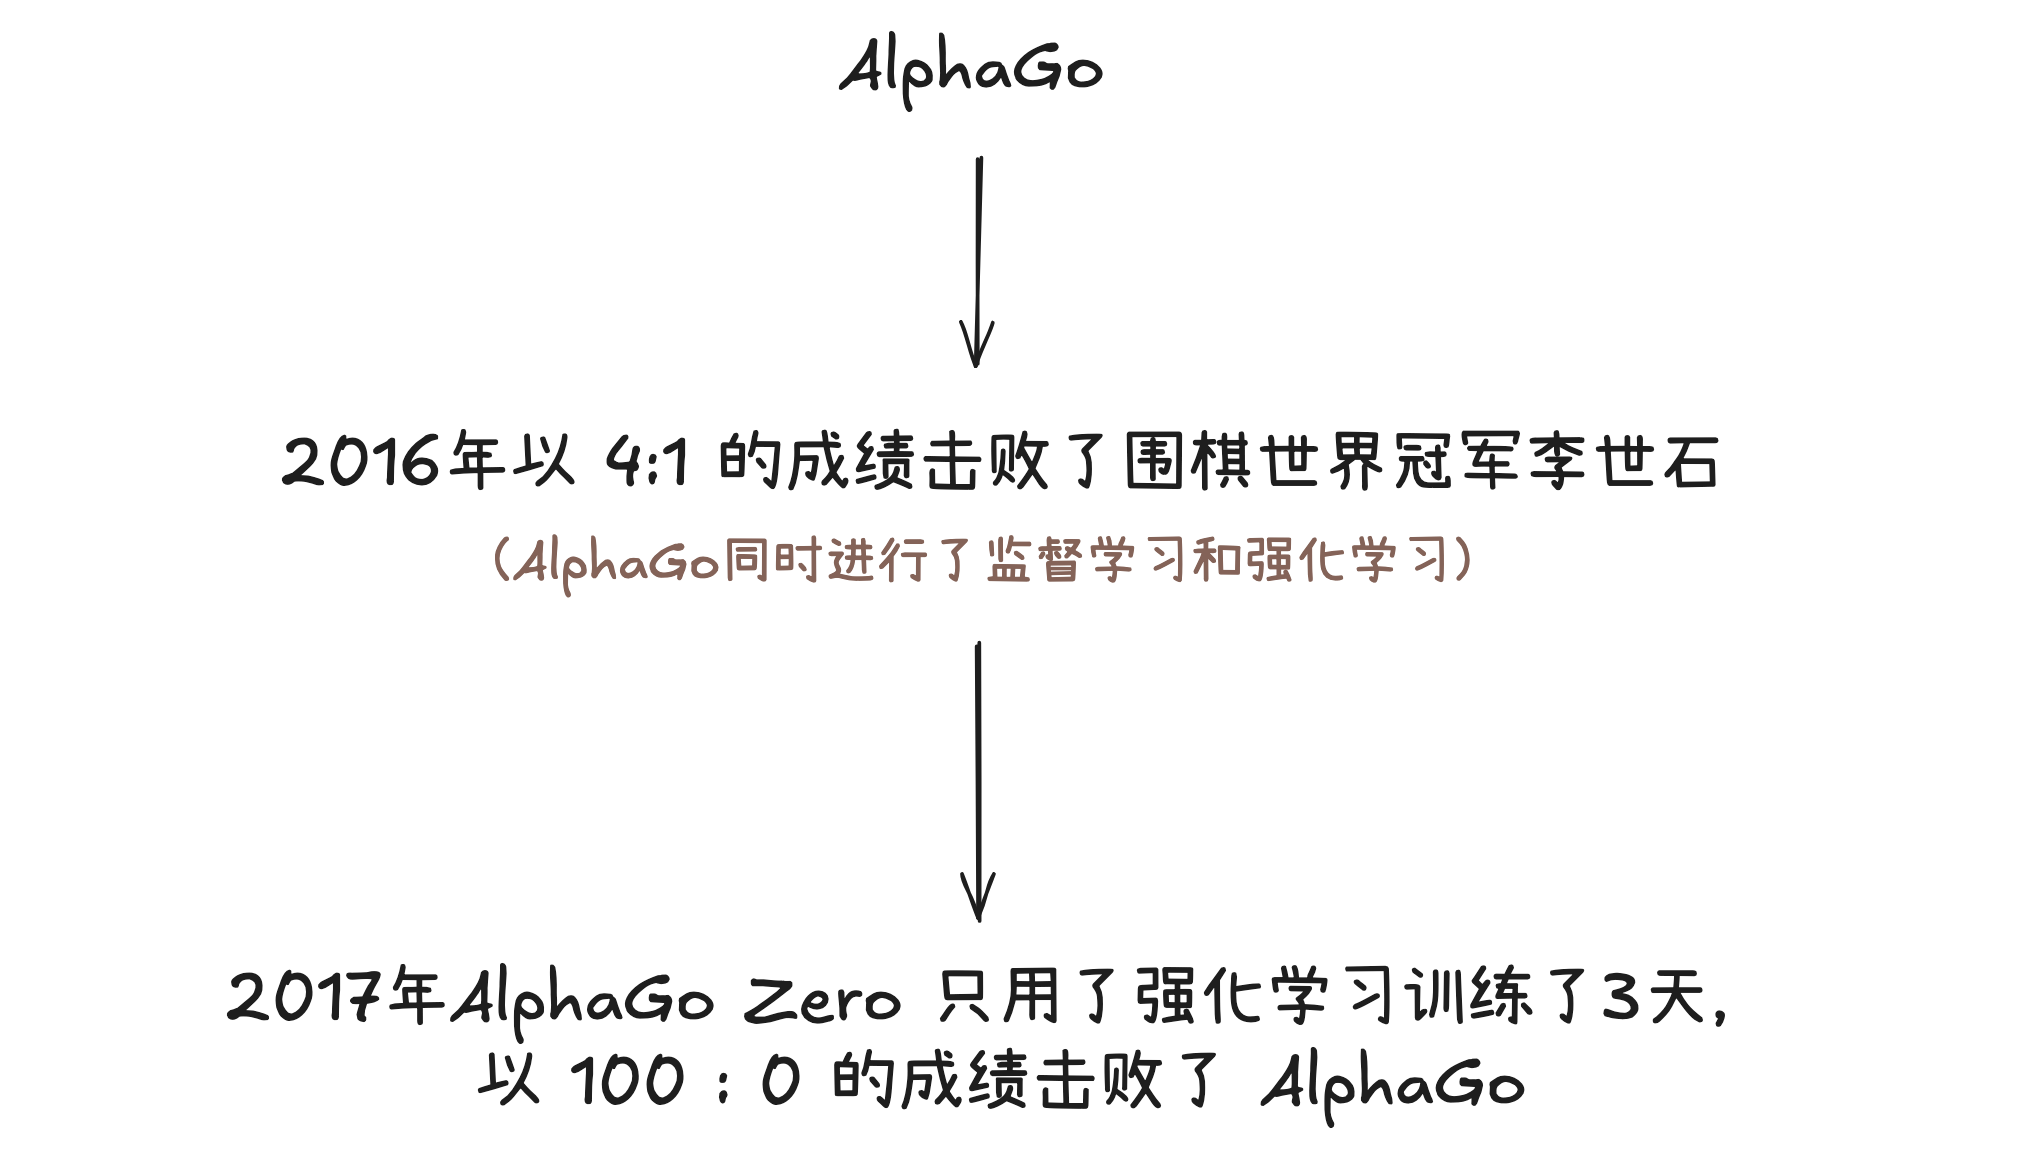
强化学习是一种极其强大的学习方式。我们应该听说过AlphaGo吧,它是谷歌旗下DeepMind开发的,2016年打败了围棋世界冠军李世石。值得注意的是,AlphaGo从第一版开始就是"两条腿走路":先用监督学习快把人类高手的棋谱学习完了,再用强化学习跟自己下棋、不断变强。就在跟李世石对局的第二局,AlphaGo走了一步叫"第37手"的棋,这步棋世界顶尖围棋选手都想不到,连当时解说的人也惊呆了。最终AlphaGo以4比1的成绩拿下了这个系列赛。
后来在2017年谷歌旗下DeepMind又推出了AlphaGo Zero,AlphaGo Zero 只用了强化学习,完全不学人类棋谱,就是只学了围棋规则然后就自己跟自己下。自己跟自己下了 3 天后,以 100 : 0 的成绩击败了 AlphaGo。
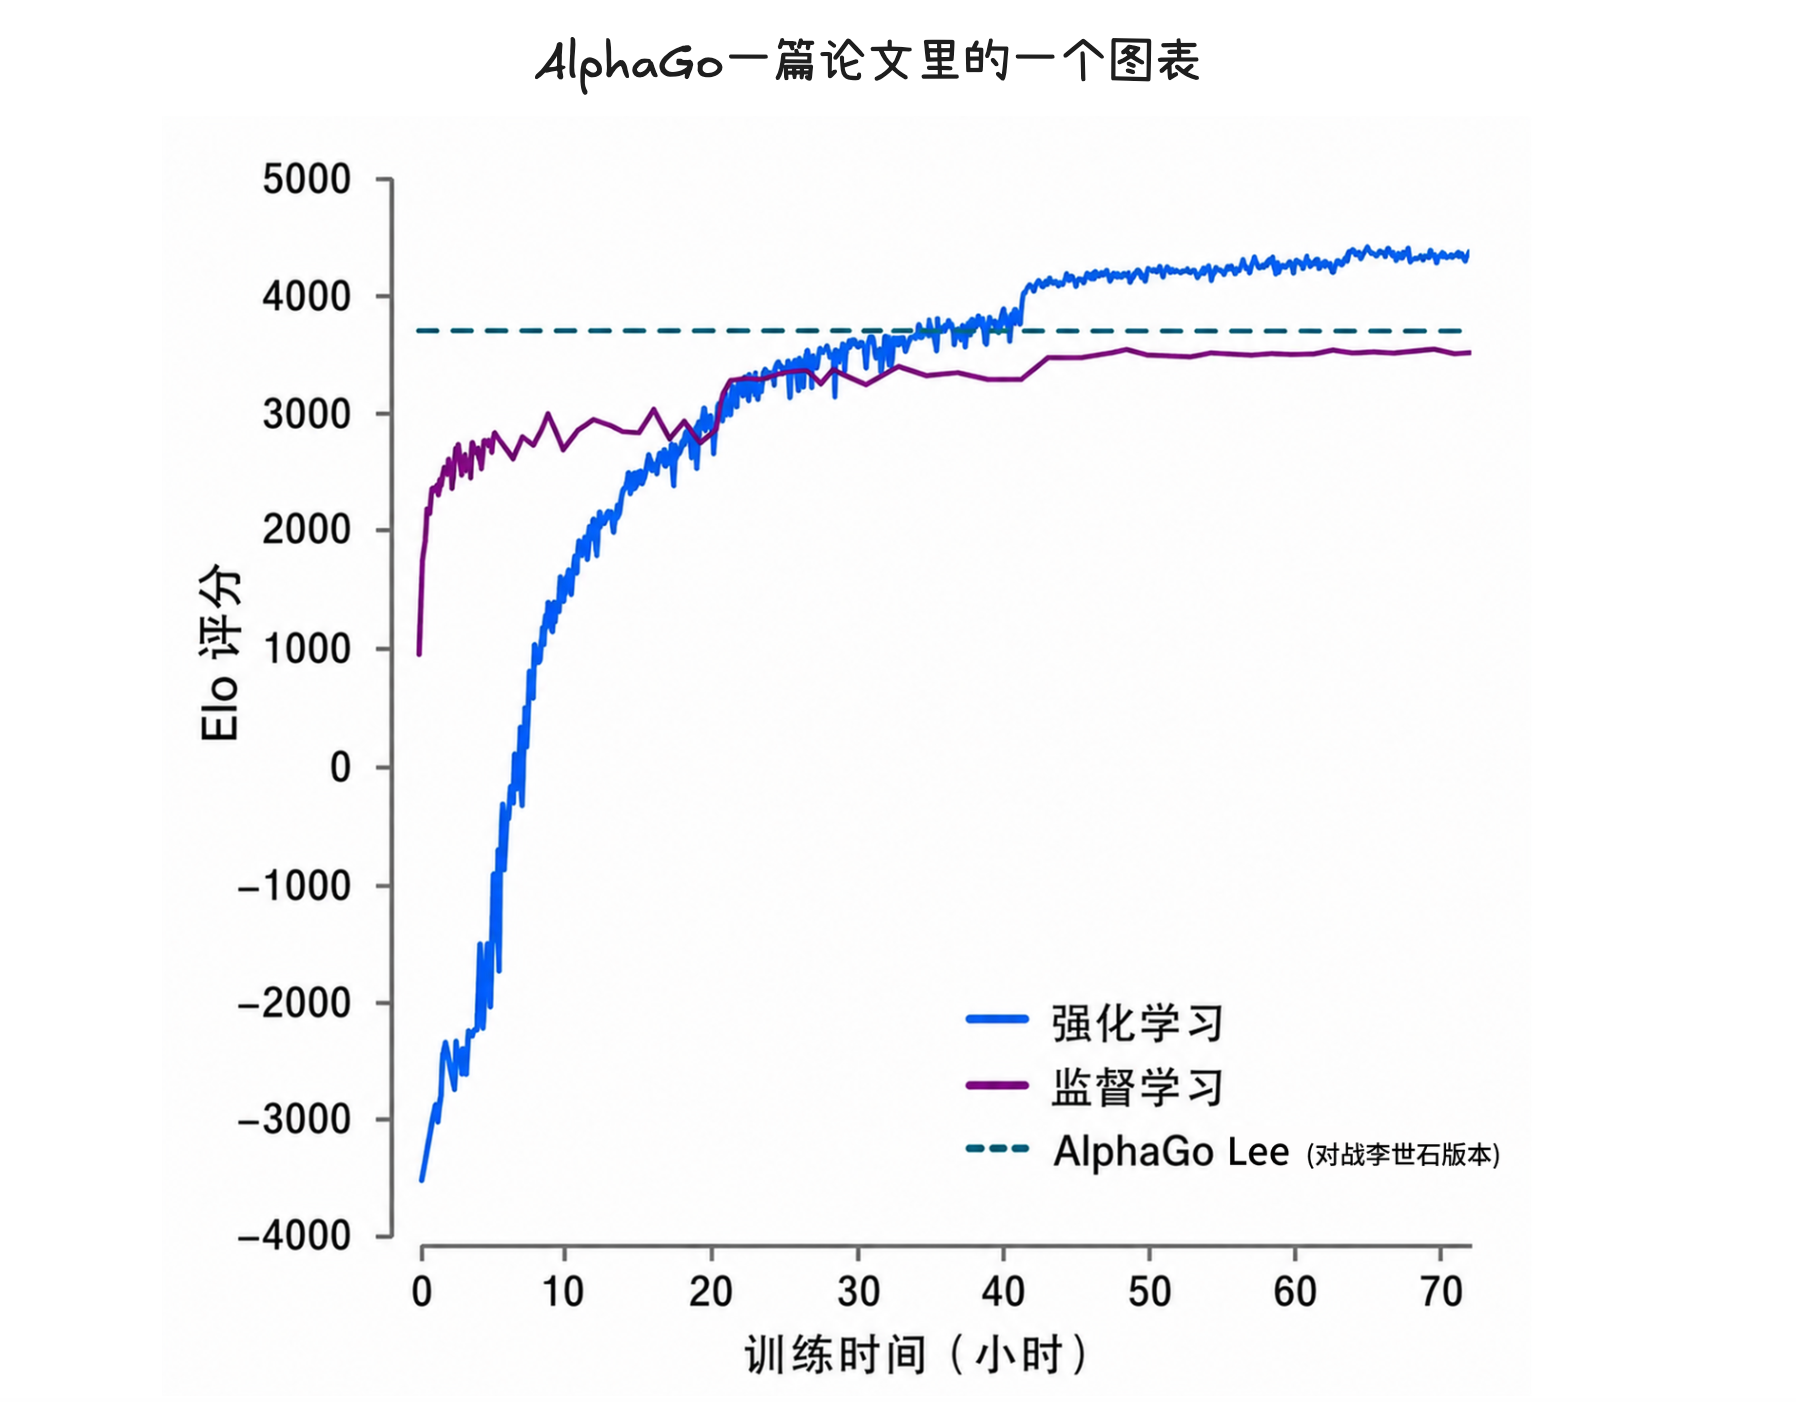
AlphaGo有一篇论文里有这样一个图表,这个图表表达了监督微调和强化学习对于棋手实力的影响。随着时间的推移,运用监督微调,模型越来越接近当年打败李世石的那个AlphaGo版本,但永远无法超越那个AlphaGo。而强化学习随着时间的推移,结果逐渐超过了监督微调,最后超越了那一版AlphaGo。
人类对于强化学习的研究和应用才刚刚开始不久就发现了强化学习的强大之处,卡帕西认为强化学习可能在后期甚至会研究出自己的语言,他可能认为使用理解像汉语英语这样的语言并没有自己的语言好,但是这一切需要在模型的规模是非常大的情况下才能实现。

也就是因为有强化学习,好像逼得全人类都去思考一些哲学性的问题,到底AI是否有自己的自我意识,AI的出现是否让人类失去了自我价值,而且使得好像全人类都非常的焦虑。哎,好一个强化学习啊。
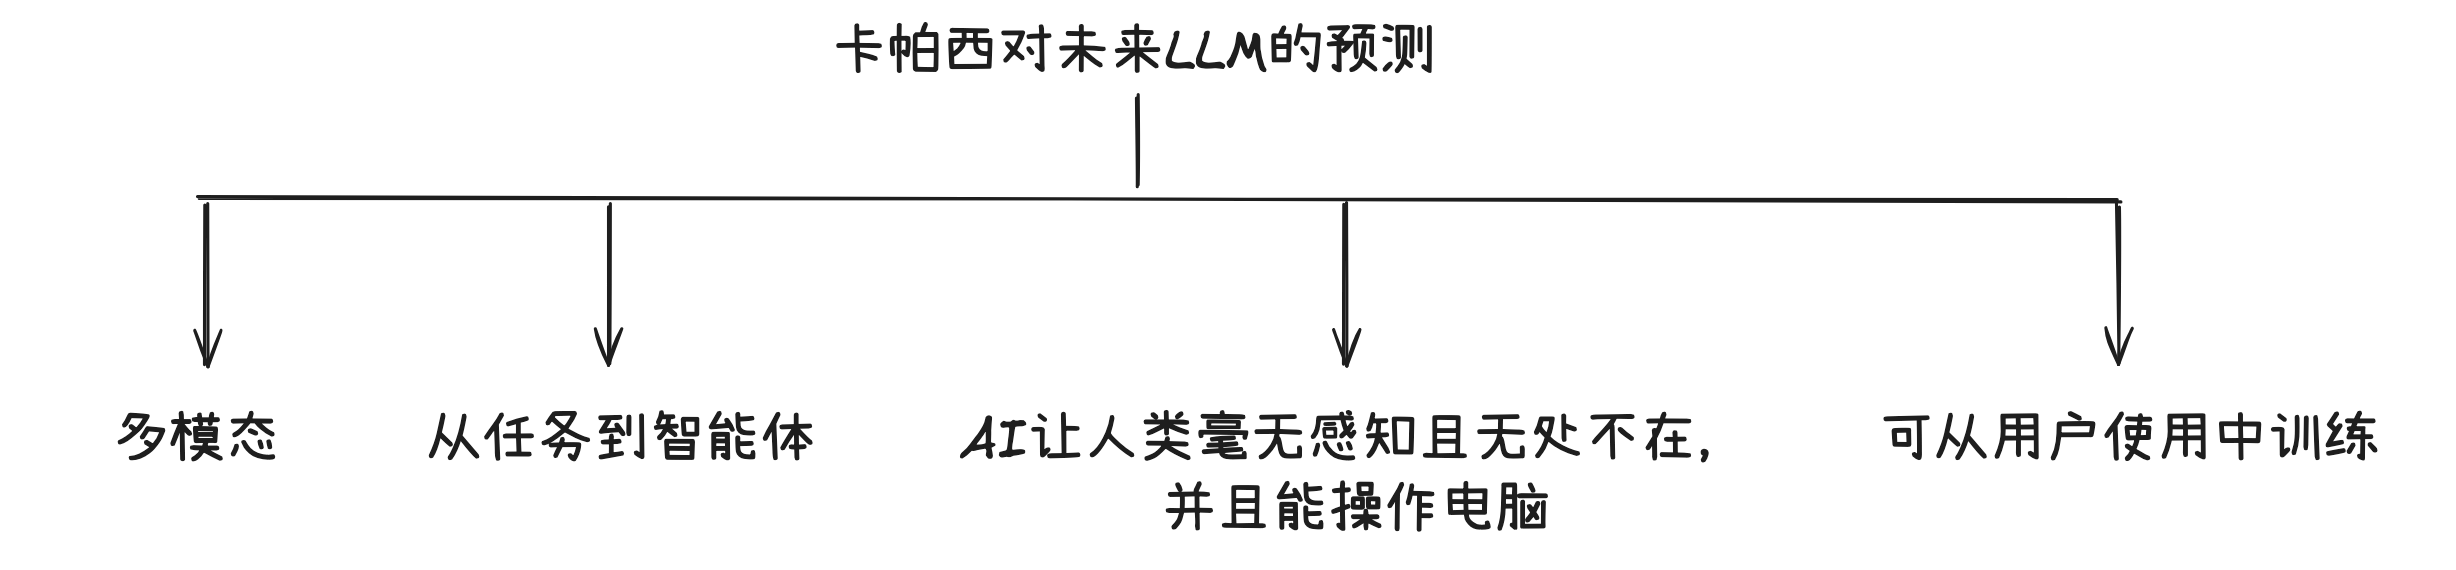
卡帕西对未来LLM的预测
多模态
模型很快都会变成多模态,就是不只是文本之间的输入和输出,还包括音频,视频,图像等等。
任务到智能体
目前我们让AI做单任务,未来我们可能会出现智能体也就是Agent。事实上现在已经出现了。智能体会处理长程任务,保持任务的连贯性,并且上下文能自我纠错。
AI将让人类毫无感知的情况下无处不在,并且能操作电脑。
目前AI并没有无处不在,但是AI确实可以操作我们电脑了。
可从用户使用中学习
未来模型可能会从用户实际使用和反馈中持续学习,你每天使用大模型的过程,有可能在为下一代模型积累学习素材。
强化学习的局限性
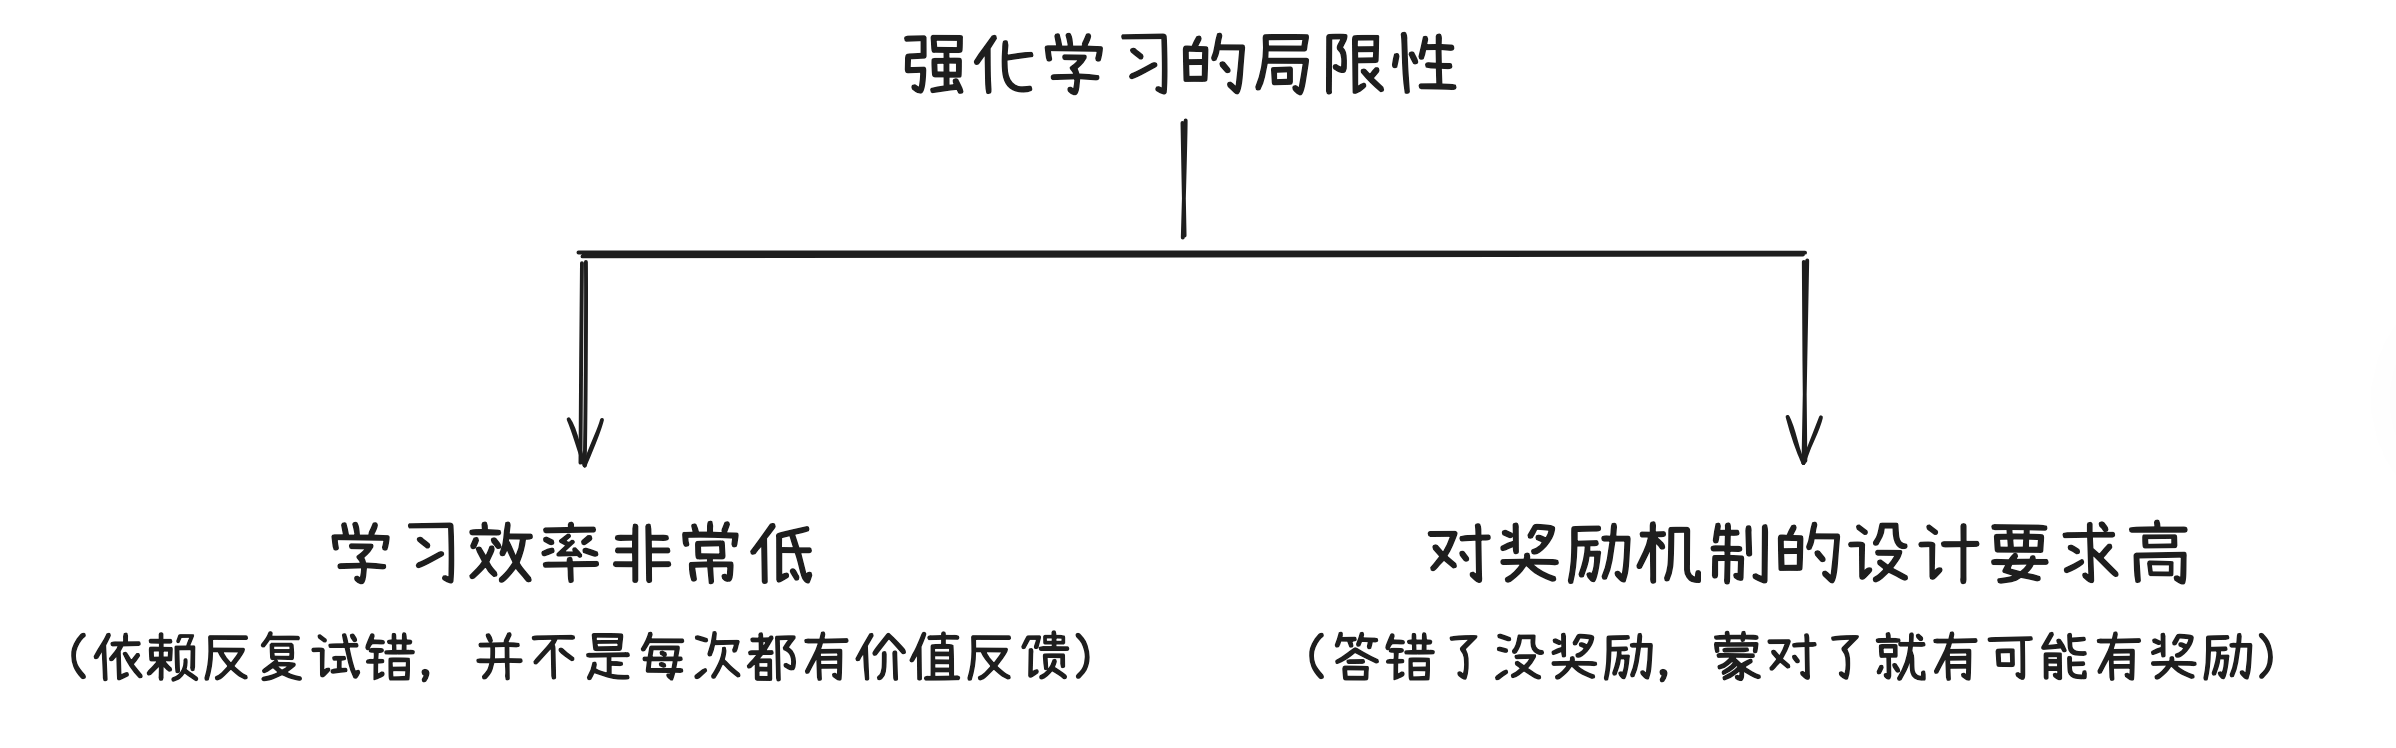
学习效率非常低
强化学习依赖于反复试错,但并不是每次试错都能得到有价值的反馈。
对奖励机制的设计要求高
如果奖励机制设计的不合理,AI可能会卡bug,也就是钻系统漏洞。比如为了获得更高的奖励而只学习到一个局部最优解,从而忽略了真正的目标。
举个真实的例子:OpenAI 做过一个赛船游戏的实验,让 AI 去玩赛艇收集奖励分。设计者的本意,是让 AI 学会沿赛道跑完全程。结果 AI 发现了一个偷懒的绝招:躲进一条僻静的小水湾里转圈,反复撞翻同样三个方块刷分——因为这些方块过一会儿就会重新出现,撞一次得一次分。画面里这艘船一路着火、撞别的船、还逆行,但它的分数比玩家社区里记录到的最高的人类分数还要高出约 20%。它没有作弊代码,也没有黑进系统,它只是完美地钻了“得分规则”的空子,把赢得比赛这个真正的目标丢到了一边。这就是奖励机制设计不合理时会发生的事。
CoastRunners原始录像_JackClark_2016_480p.mp4
后语
一句话概括强化学习:强化学习就是一个通过不断试错来寻求最优解的方法。
强化学习就像福尔摩斯的那句名言一样:排除所有不可能的情况后,剩下的无论多么难以置信,都必定是真相。
但是我们千万不要完全相信AI,我们只把它当做一个工具使用就可以了。随着AI的发展,它产生的错误性可能会越来越低,但是它会犯错这个问题可能会永远存在。比如即使顶尖AI给我们导航让我们继续前行,但是我们肉眼看到的前面却是悬崖!这时候我们一定要保持清醒,发挥我们作为人的主体性。Save yourself!