前言
想训练出像ChatGPT、豆包、DeepSeek这类的大语言模型(LLM),我们大致需要三个阶段。第一阶段:预训练;第二阶段:监督微调;第三阶段:强化学习。其中,二三阶段也可以统称为后训练。
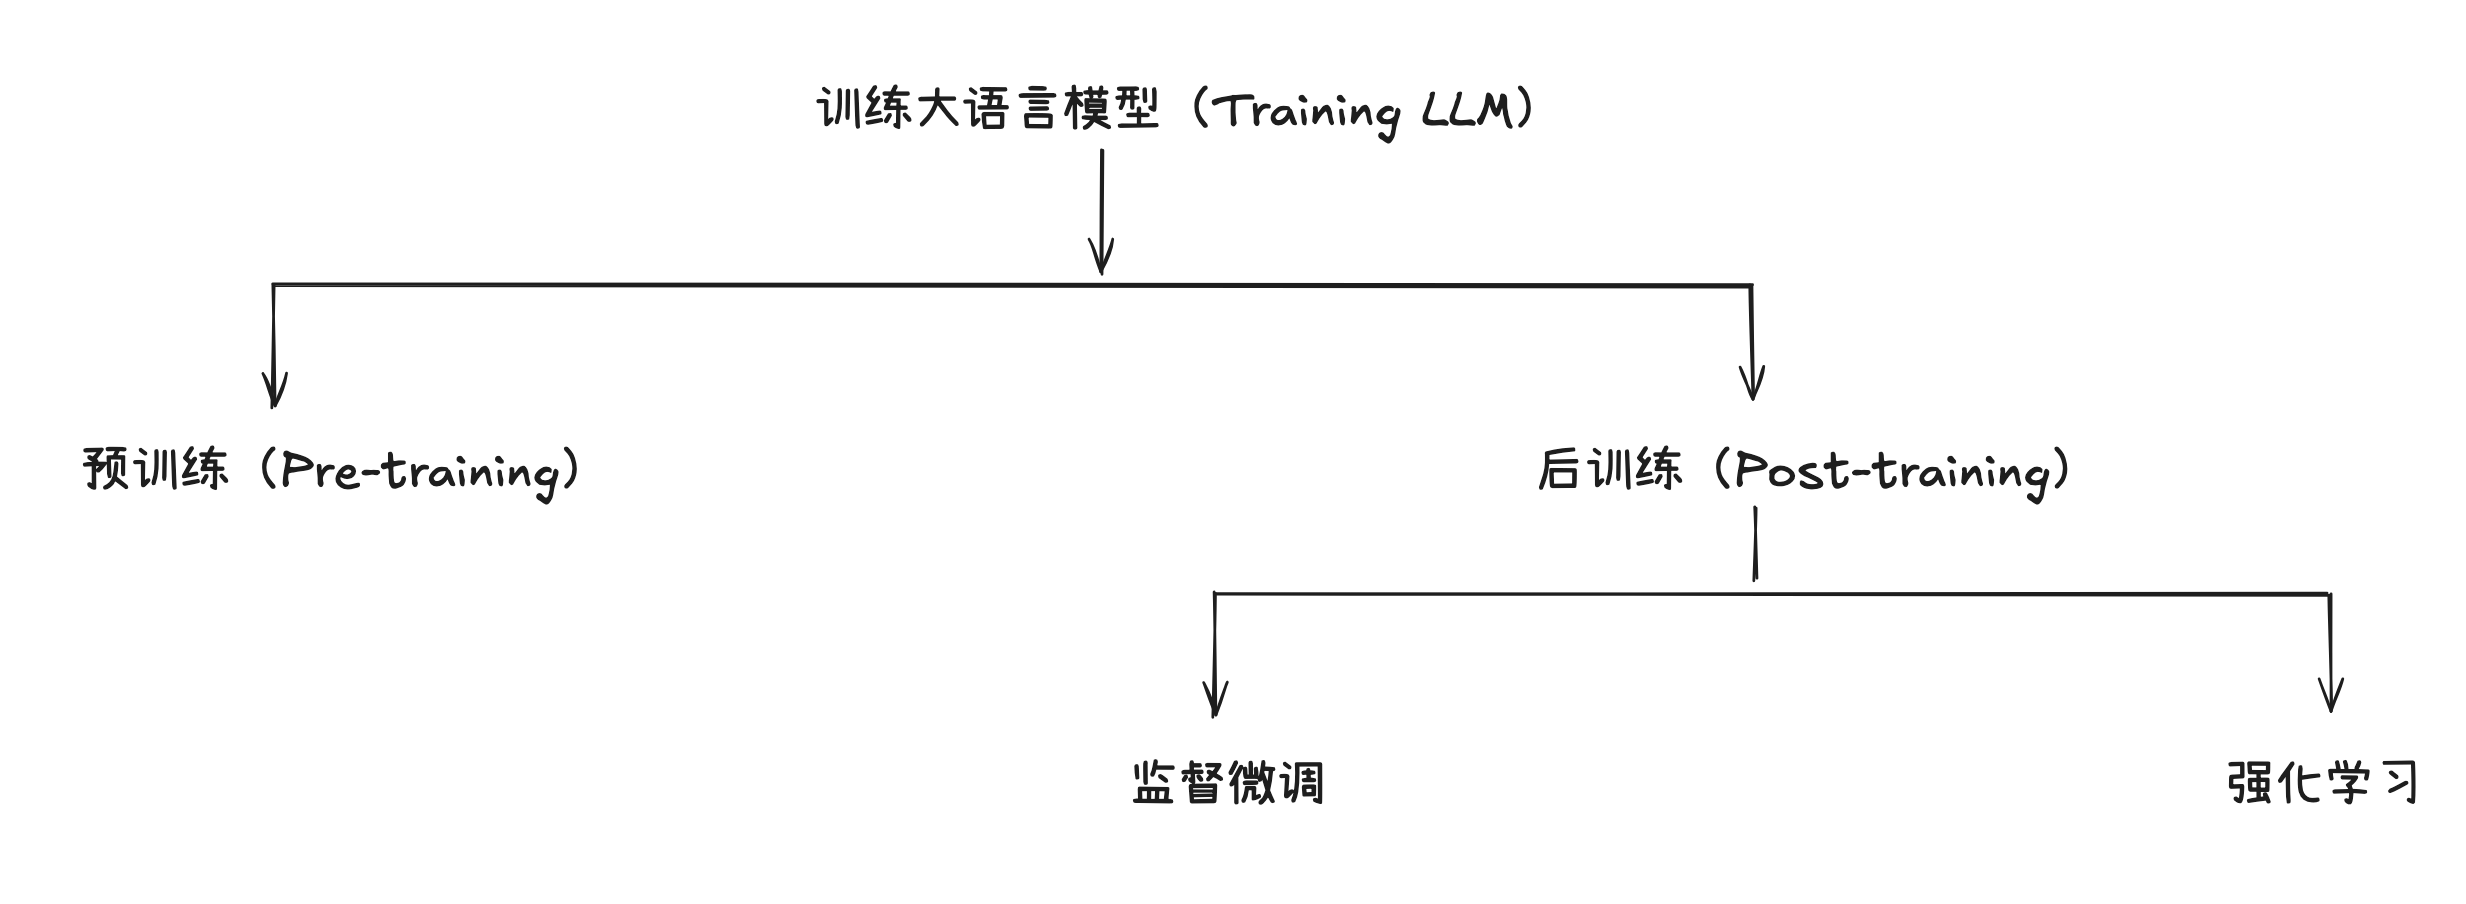
我们可以大致把预训练分为三个步骤来进行,第一步:抓取并处理数据;第二步:Token化;第三步:训练神经网络。
第一步:抓取并处理数据
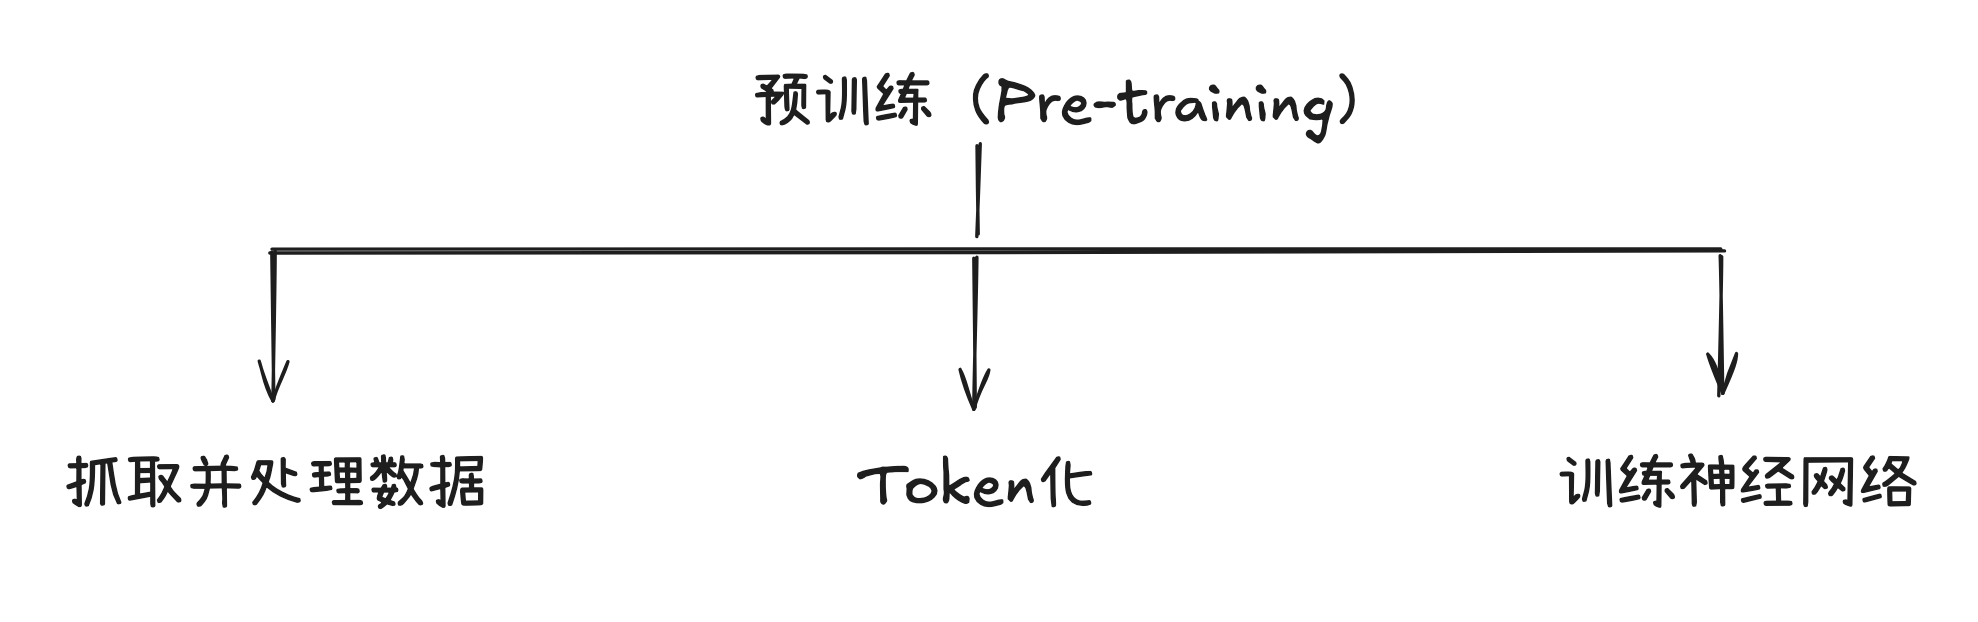
第一步抓取并处理数据,就是从互联网上抓取数据内容并进行处理。我们希望这个内容,数量足够多、质量足够高、种类足够丰富。
有一个叫Common Crawl的组织,截止2026年已经在互联网上抓取了3000多亿个网页的内容。当然直接抓取过来的这些网页的内容比较乱,我们需要进一步处理。有一家叫Hugging Face 的公司设计了一个数据处理流程,分为8个步骤。
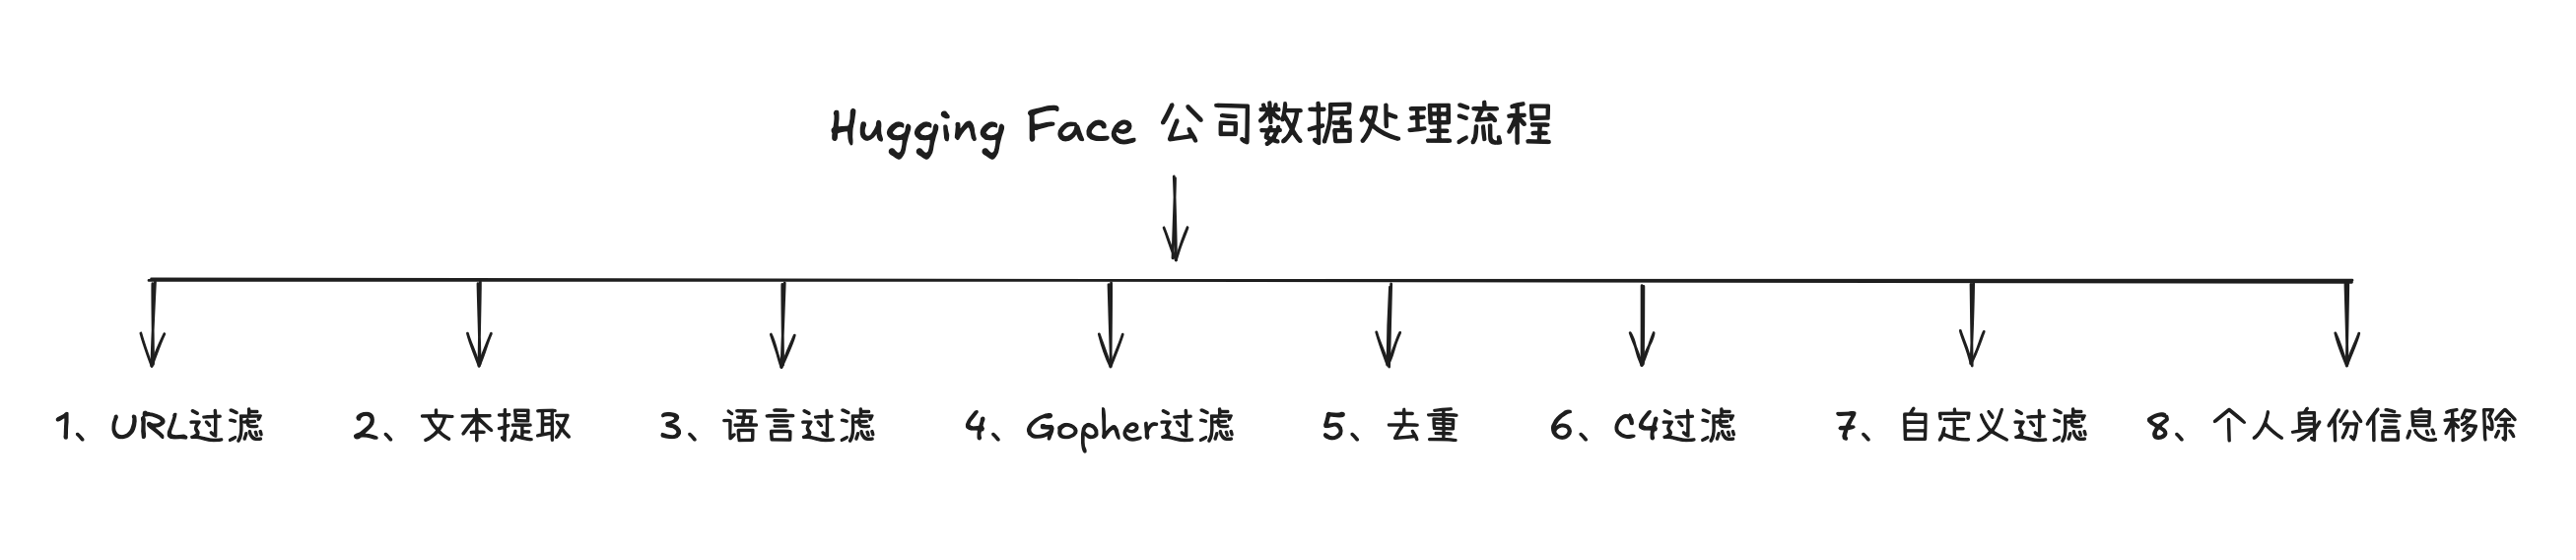
第1步是URL过滤,也就是网址过滤。我们需要过滤掉一些比如黑客网站、黄色网站、营销网站、种族主义网站等等。
第2步是文本提取。因为我们抓取的是整个网站的内容,是原始的HTML。我们不需要这个网站里的广告啊、版权信息啊,或者一些加了特效的文字。我们只需要纯文本这些字本身就够了。
第3步是语言过滤,就是AI模型公司可以选择性的来决定按照什么比例来抓取哪种语言网页,比如65%用来抓取英文网页,30%用来抓取中文网页,5%抓取其他语言网页。
第5步去重,就是去掉重复或高度相似的网页。
第7步是自定义过滤,就是可以根据具体需求加一些个性化的筛选规则。
最后一步就是个人身份信息移除,把身份证号、手机号、邮箱号、住址等等的个人隐私敏感信息去除掉。
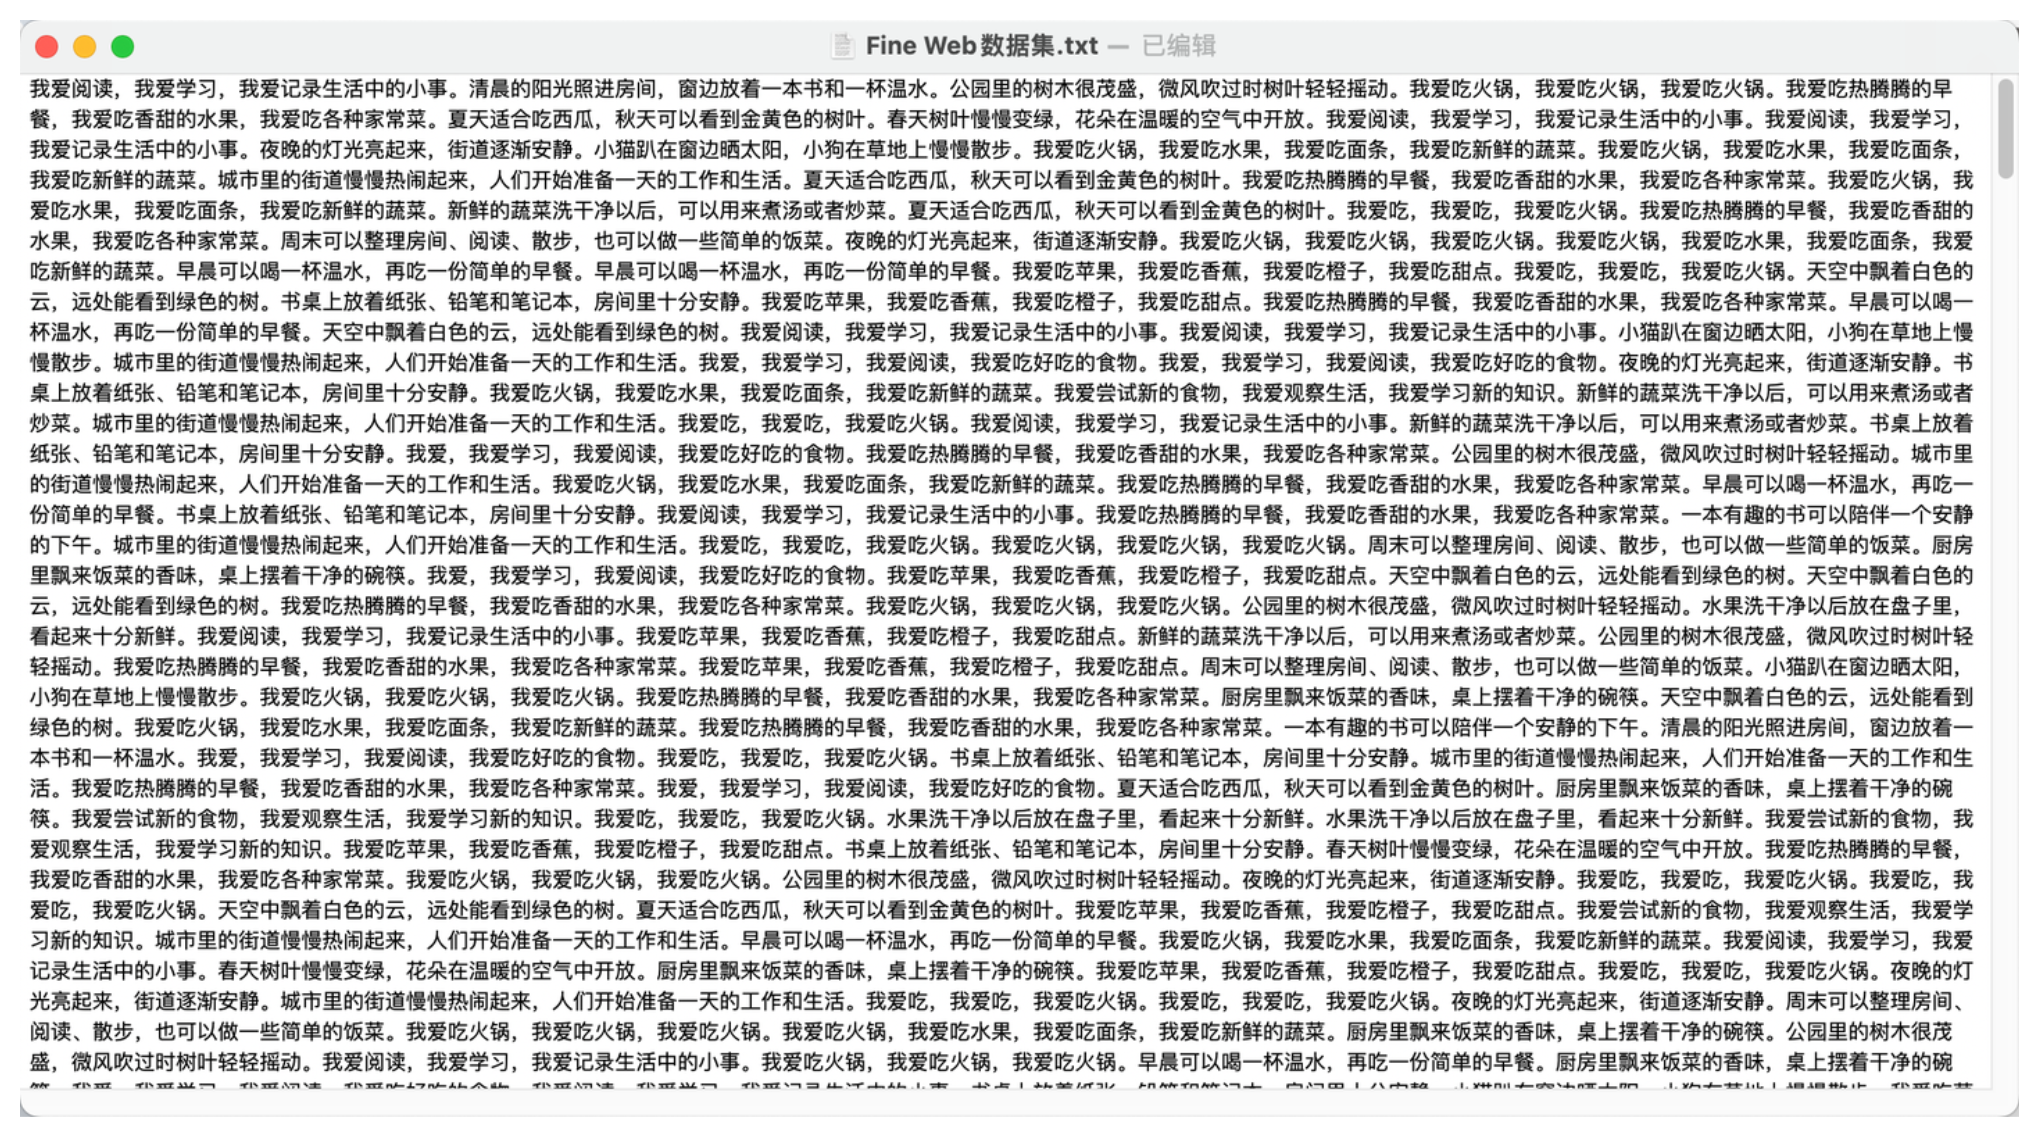
最终Hugging Face把Common Crawl抓取的这些网站,经过这一套流程后,制作出了一个叫 Fine Web 的大规模预训练数据集。这个数据集其实就是大量的类似于这样的txt文本。
第二步:Token化
第二步:分词,也就是Token化。什么是Token?为什么要进行Token化?
这一步可能稍微有点难理解,我建议大家把这部分多看两遍。
好,首先Token是大模型阅读文字的基本单位,我们人类阅读文字是一个字一个字读,大模型是按照一个Token一个Token读。大家听不懂先别着急,后面我们还会再讲到Token。
因为计算机电脑不懂我们人类的语言,计算机只能处理数字0和1,所以我们需要把人类语言转换成计算机能处理的语言。这时候人类设计了一套叫 UTF-8 的编码规则,它能把文字转化成计算机能处理的0和1。我们把这个 Fine Web 数据集的文字用 UTF-8 处理成一个个字节,是这样的。
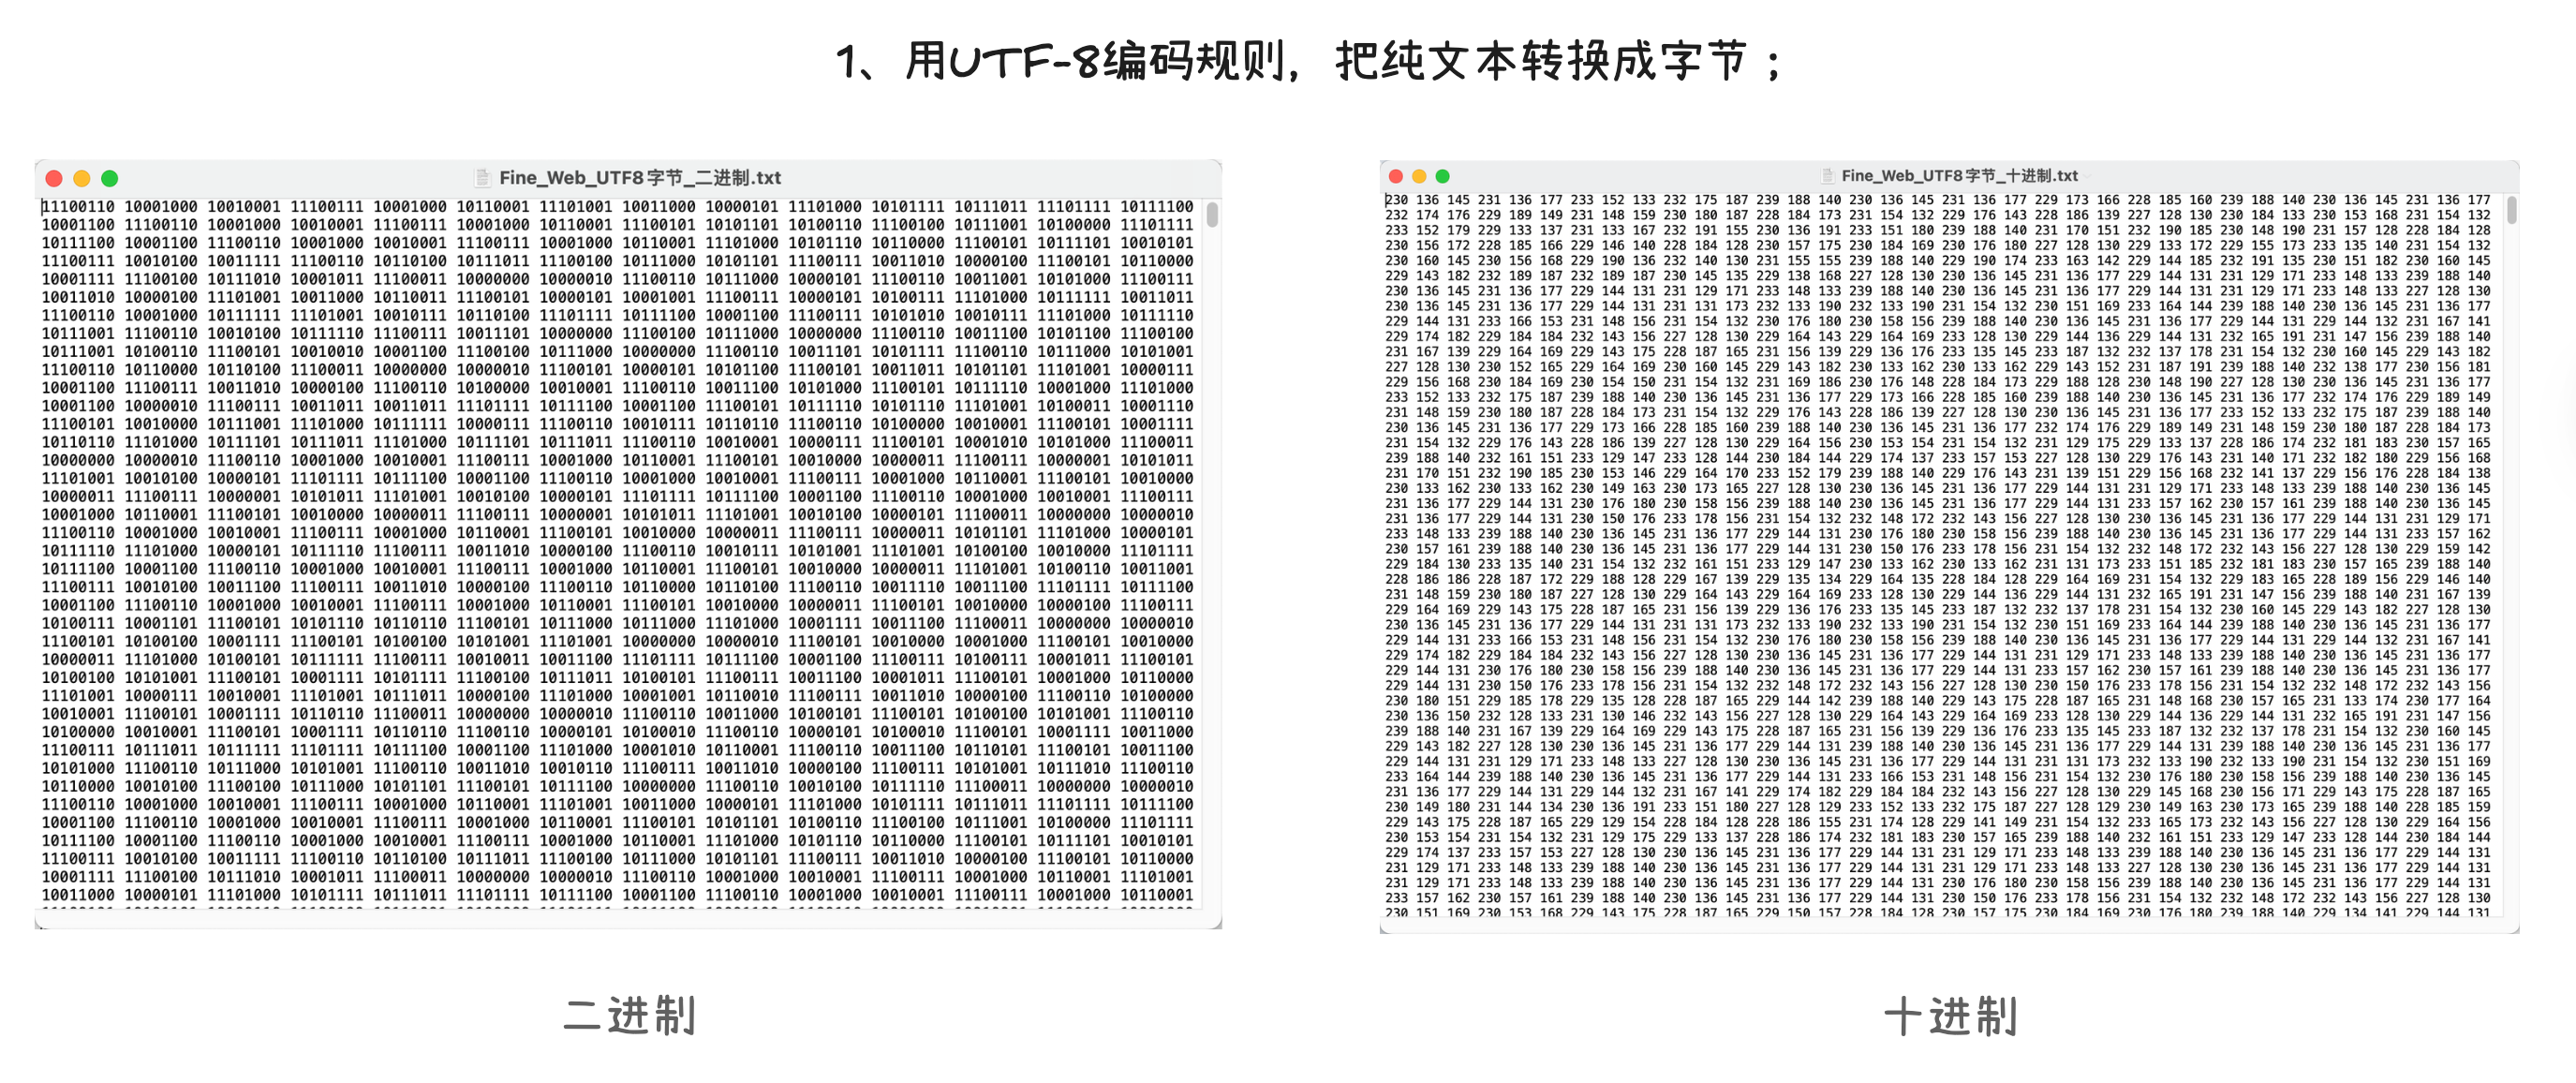
我们可以看到全是0或1,这里的0或1就是计算机能处理的数字。0或1这是字节的二进制显示法,这里是字节的十进制显示法。二进制显示法太长了,不方便我们观看,我们直接看十进制显示法吧。二进制和十进制只是显示的样式不一样而已,它们都是表示同一份数据。十进制显示法的字节就是0到255之间的数字,我们可以把这里的数字看作成一个ID符号,就像你的工号一样,它只是一个数字代号,不表示数字大小。
这时候我们引入一个算法叫BPE,BPE发现[230, 136, 145]和[231, 136, 177]会经常一起出现,[230, 136, 145]代表汉字“我”和[231, 136, 177]代表汉字“爱”,它就会把这俩ID符号[230, 136, 145, 231, 136, 177]合并成一个,比如叫256(假设代表汉字:我爱)。这个256,就叫Token ID。而“我爱”这个整体,就叫一个Token。
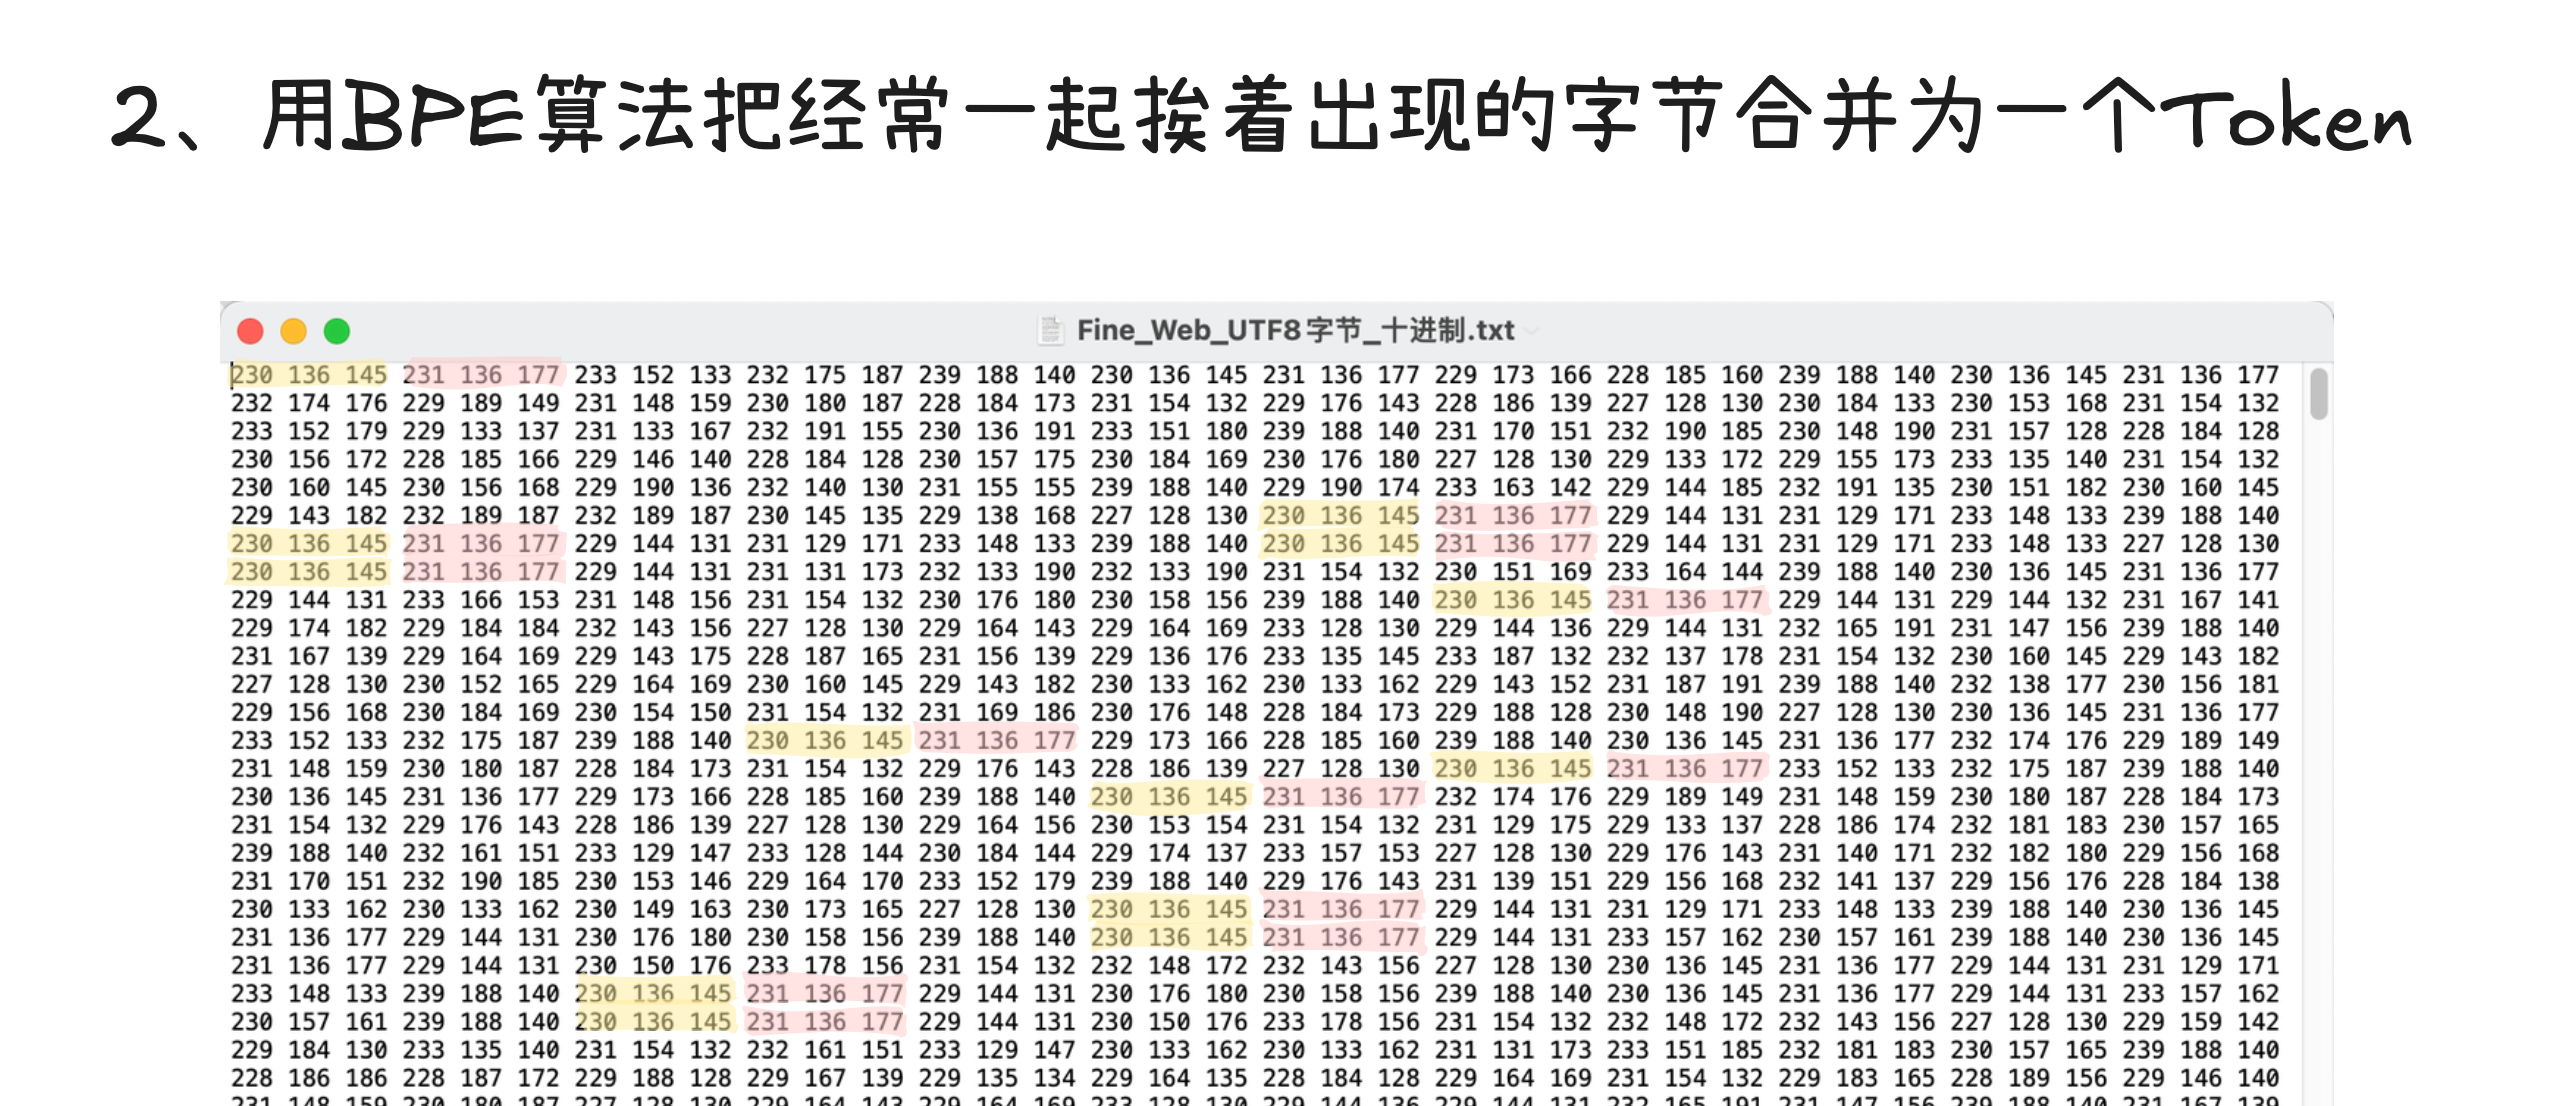
这样序列变短了,但是数字的丰富度也从只能显示0~255的数字,增加到了256甚至以上。BPE又发现“我爱”和“吃”经常一起出现,就会把“我爱吃”合并成一个Token ID,以此类推,我们减少序列长度并且增加数字丰富度,这就是Token化。这样计算机处理文字的效率就提高了,我们也可以通过Token ID去训练大模型。
第三步:训练神经网络
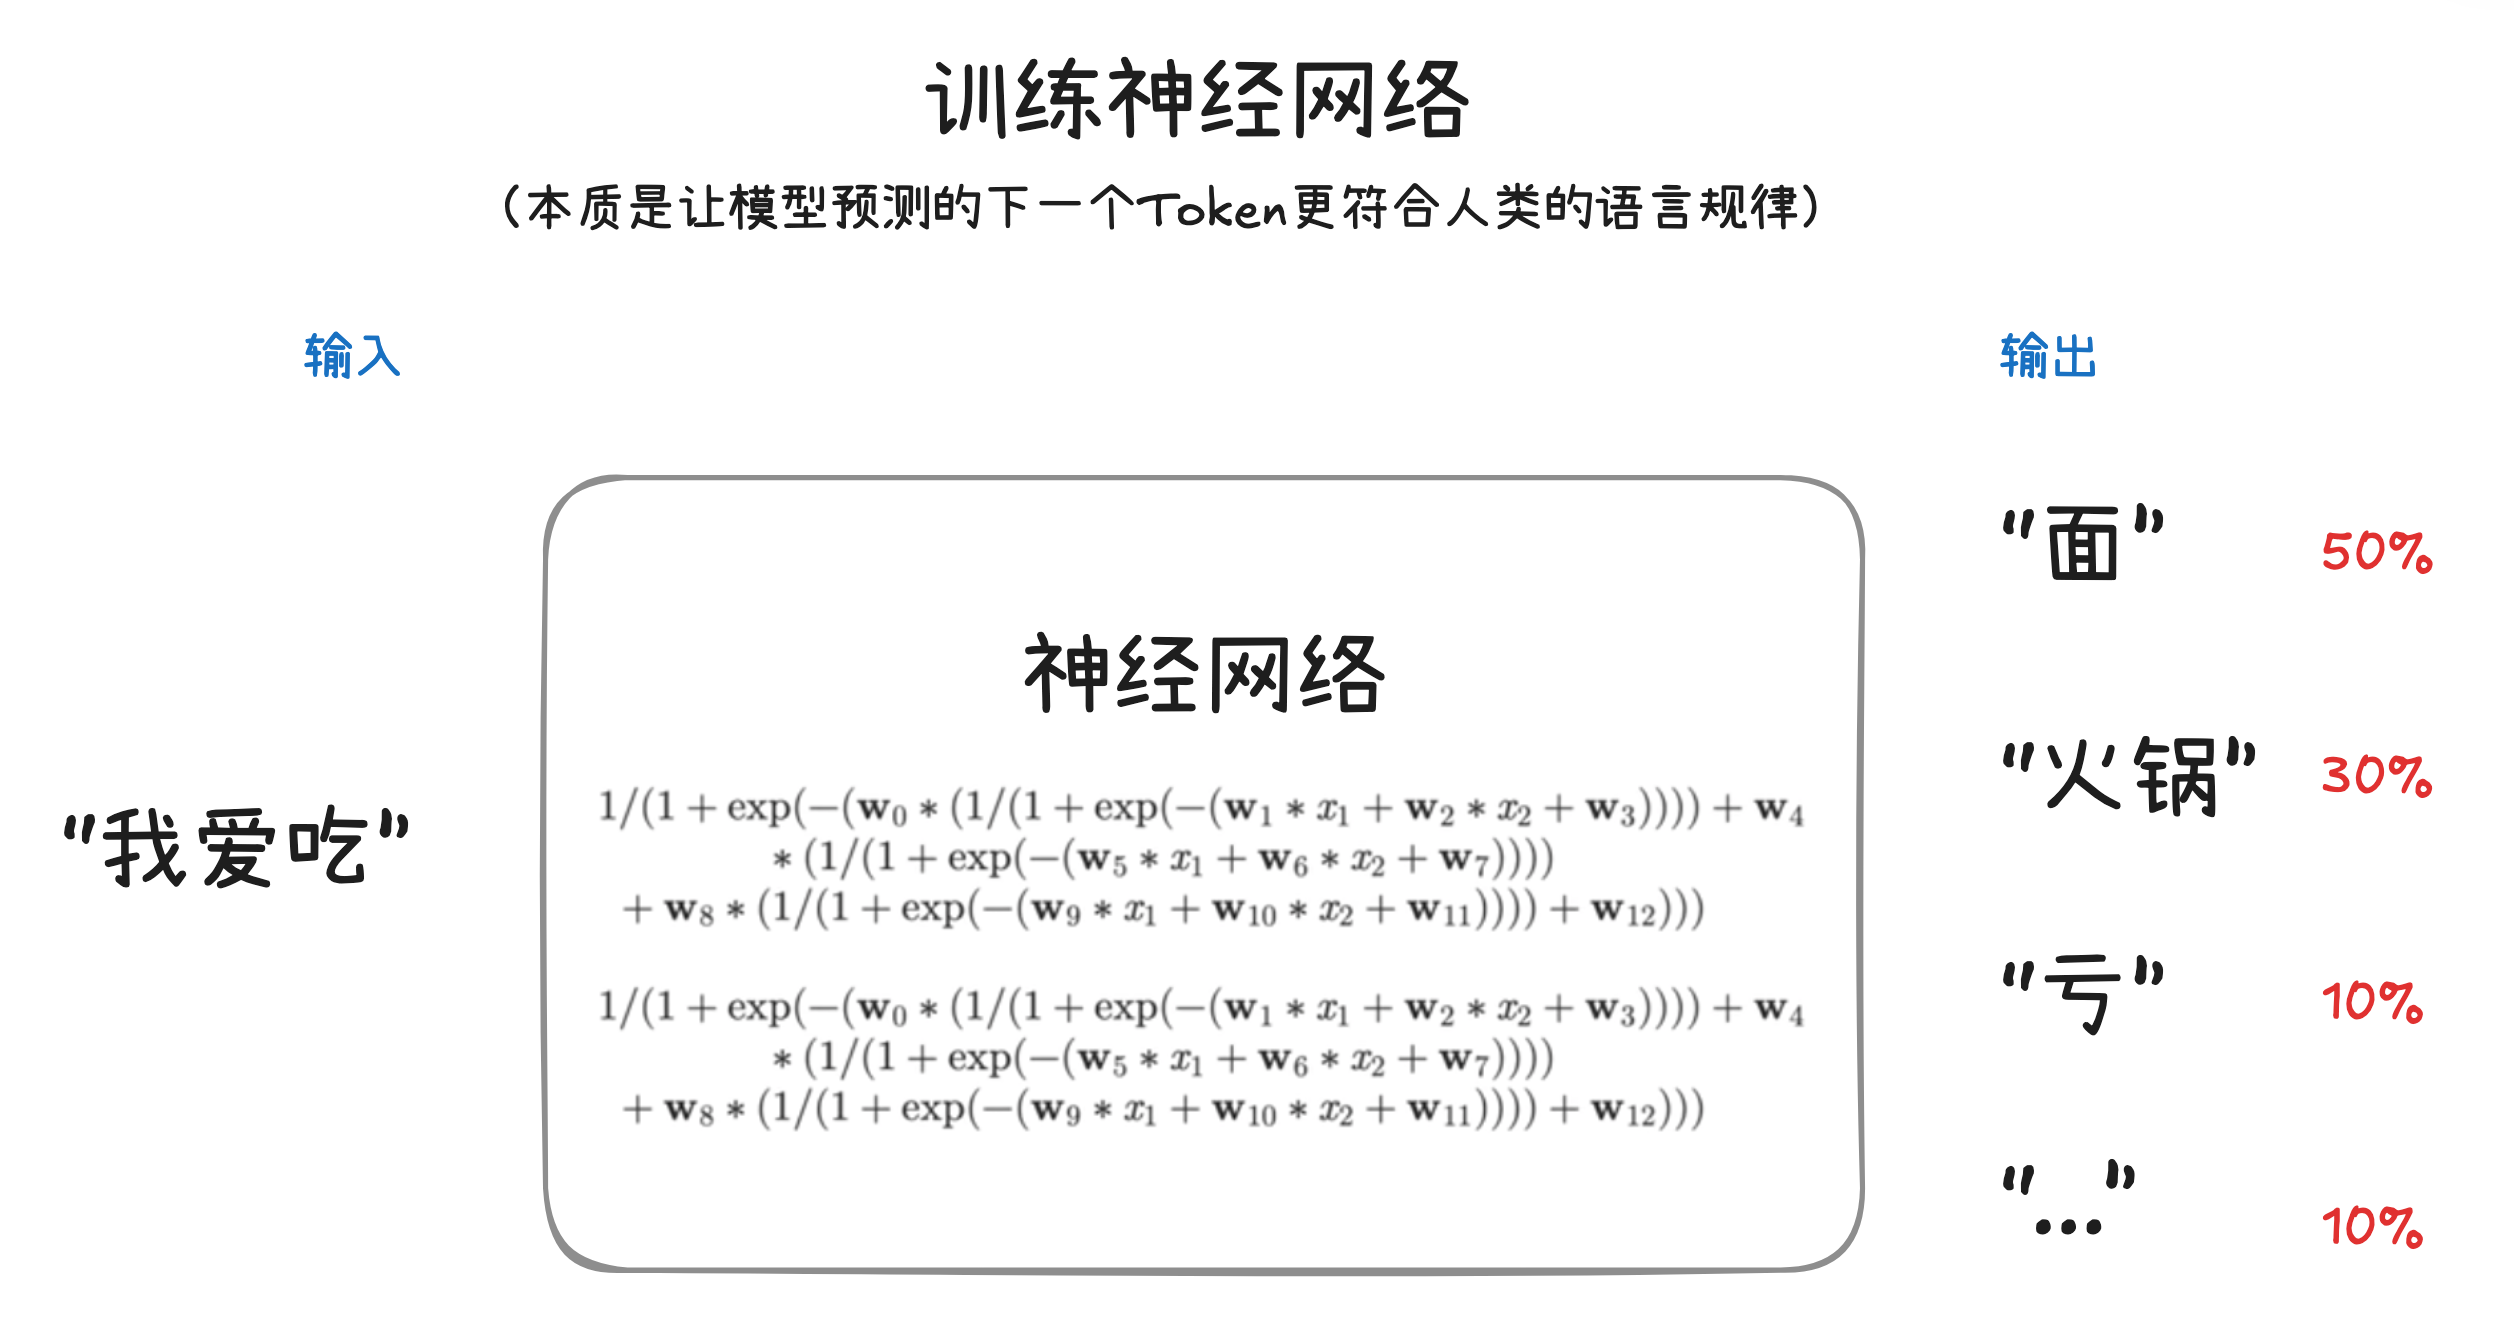
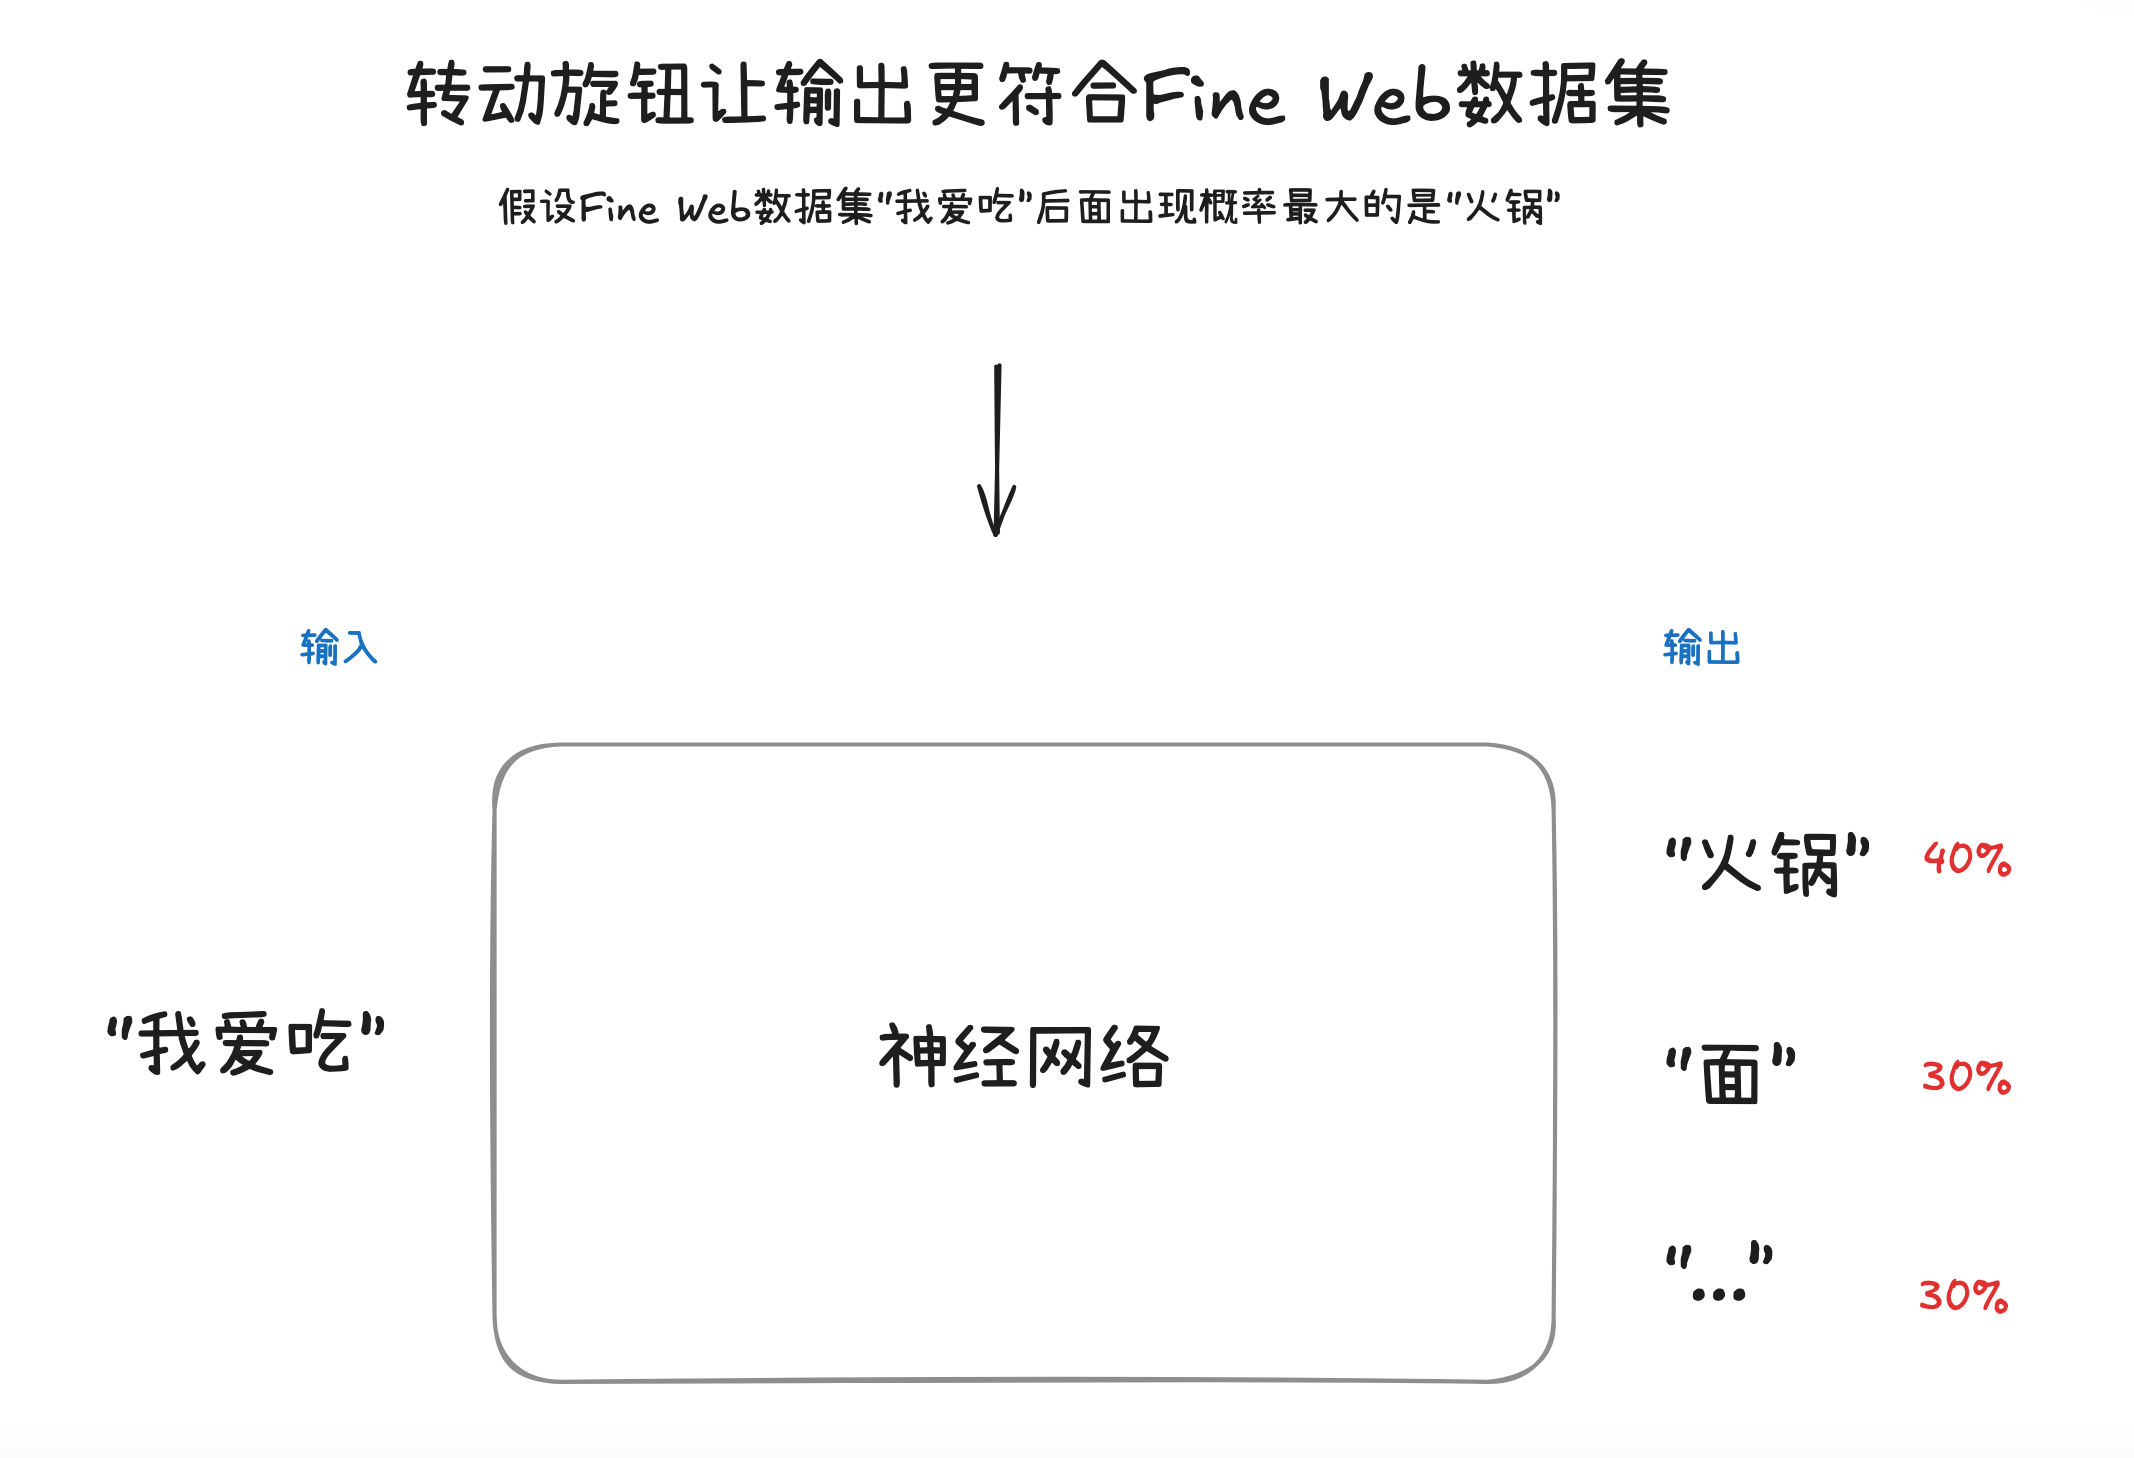
第三步,训练神经网络。训练神经网络的本质是让模型预测的下一个Token更符合人类的语言表达规律。比如我们输入“我爱吃”给计算机神经网络,神经网络需要预测下一个Token,比如它预测下一个Token是“面”的概率是50%,“火锅”的概率是30%,“亏”的概率10%。但是这里会有10万个Token甚至更多,所有Token加起来概率是100%。这些Token出现的概率是可以通过神经网络调整的,这个神经网络的本质就是超级复杂的数学函数。
但是我们可以把它理解成一个DJ台,上面有很多个旋钮。这些旋钮就是模型的参数或者权重,但是实际模型最多可能有上万亿个旋钮,转动旋钮就可以改变这10万个Token出现的概率。
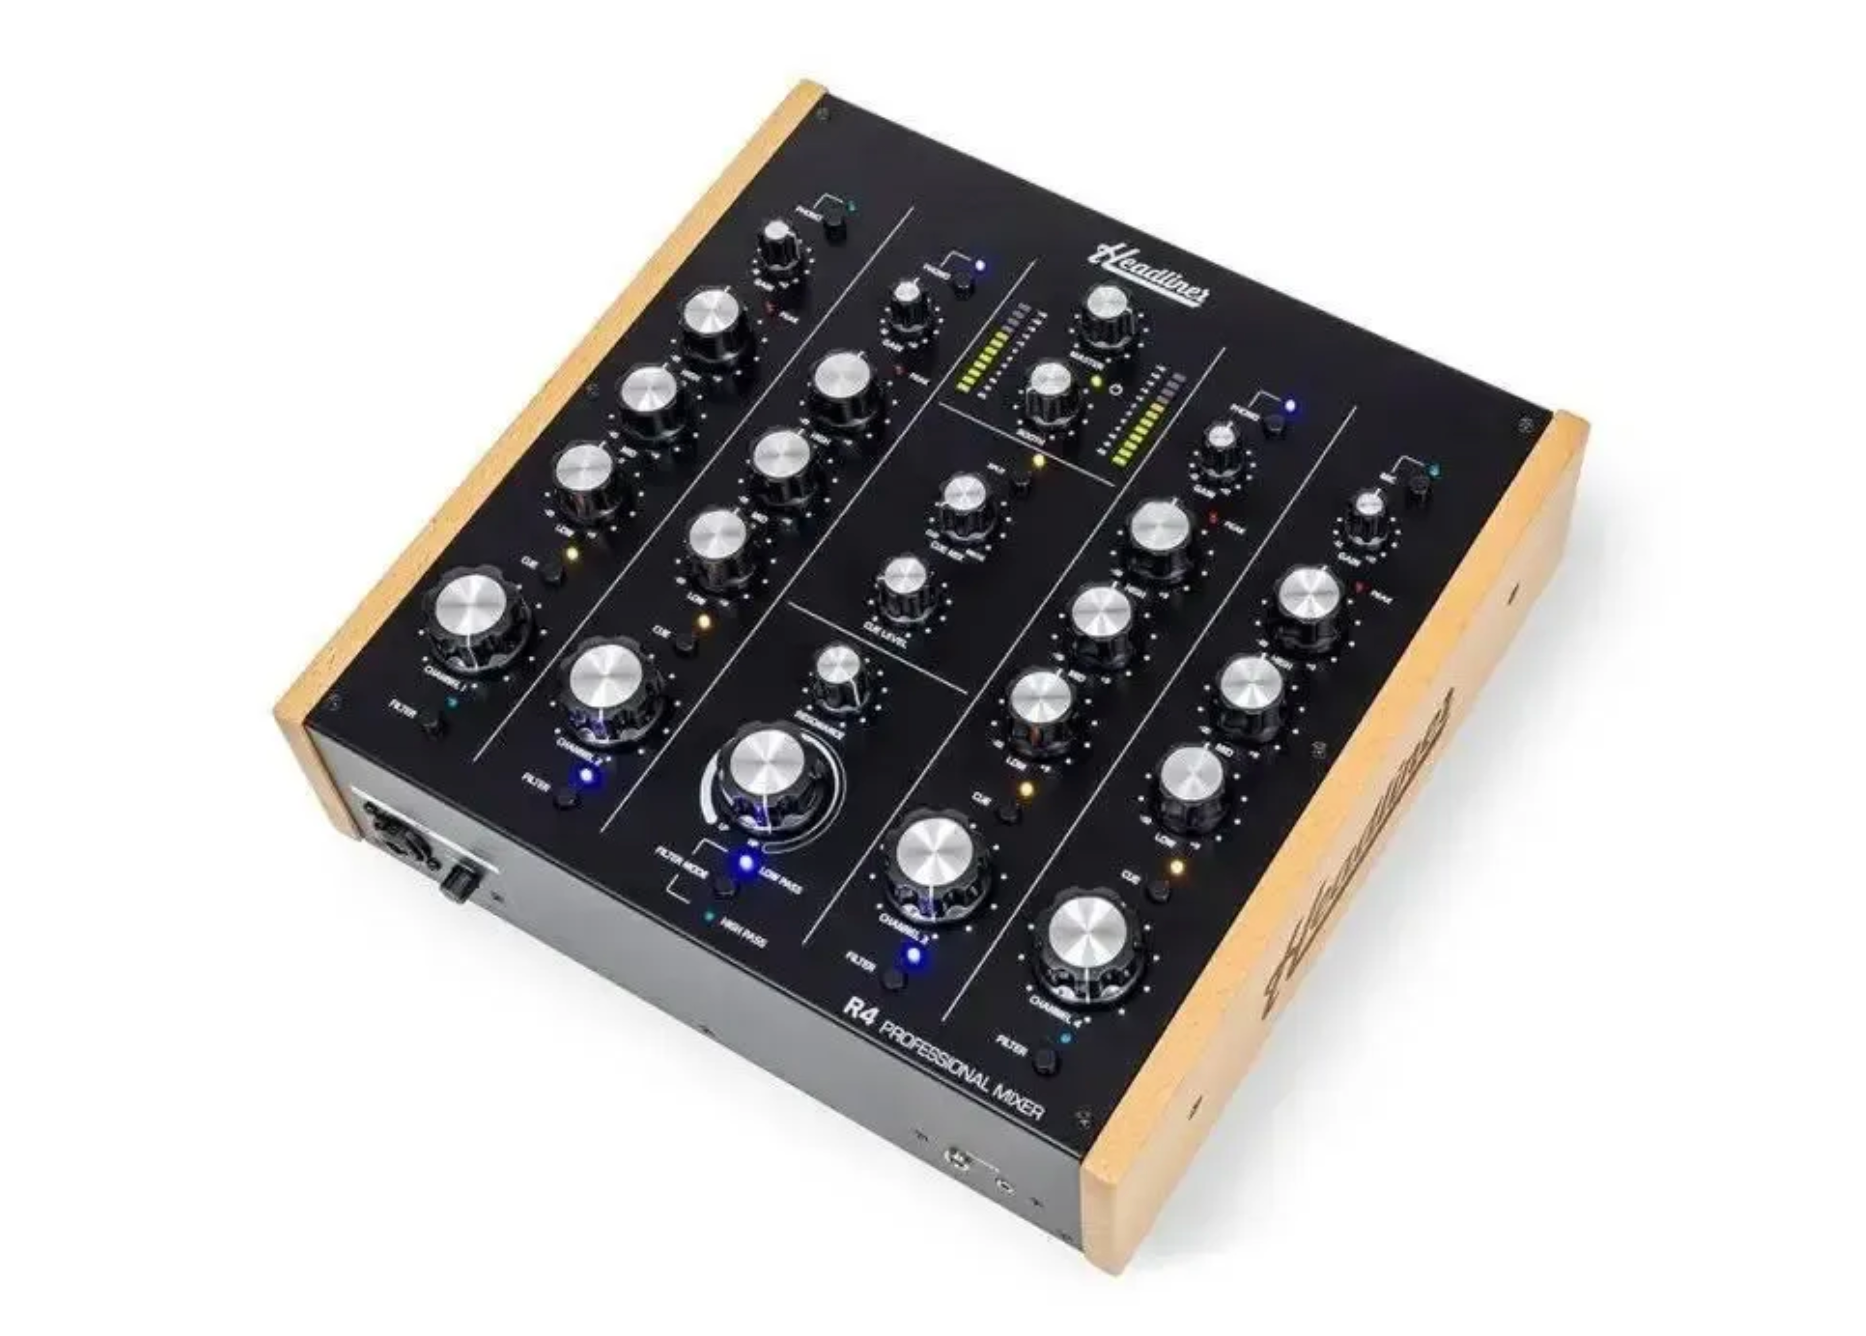
这些旋钮我们不是随心所欲的转动的,我们是要根据Fine Web数据集来转动,让模型更符合数据集里面的文字表达。比如数据集里“火锅”出现在下一个词的概率是最高的,但是模型预测出的不是“火锅”,那我们就可以通过旋钮来把“火锅”出现的概率调整成40%,把“面”调整成30%,其他的词加起来30%。把这个过程大量重复,模型就越来越接近人类输出文字的逻辑习惯,语言规律。
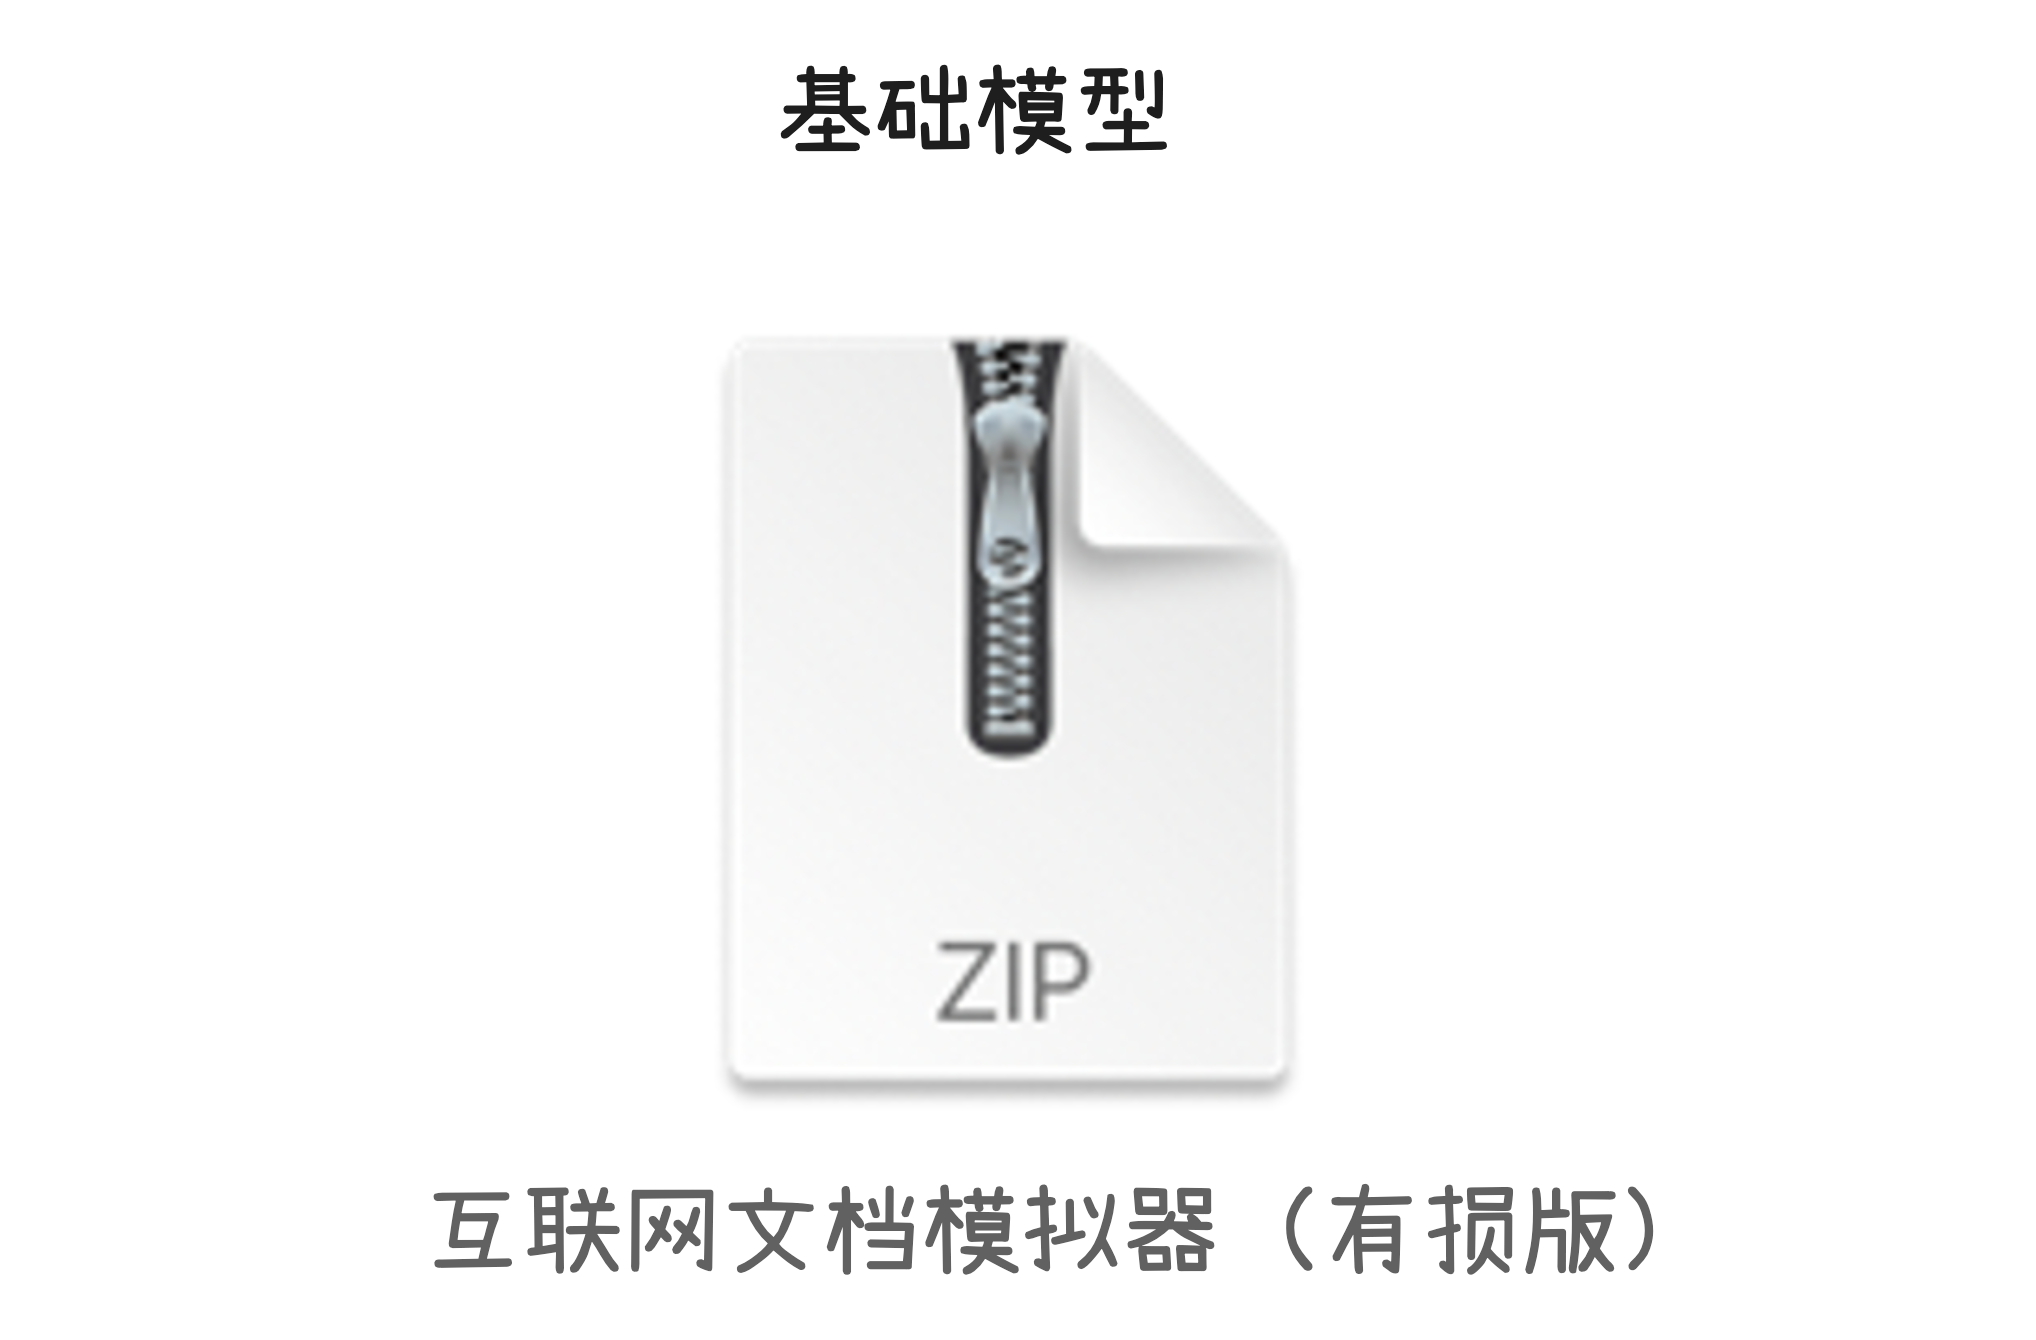
训练完成后我们就得到了参数被固定了的基础模型,这个基础模型其实就是互联网文档模拟器。这个基础模型我们可以把它想象成一个zip压缩包,但是这个压缩包是有损的,不是无损的。这也就是为什么模型有时候回答的不准确或者胡说的原因,我们把这种现象叫做AI幻觉。
现在我们来使用这个基础模型,假设我们给它输入“我爱吃”,通过神经网络后,它预测到下一个Token是“火锅”并进行了输出,然后它会把“我爱吃火锅”这几个Token一起再当做一个输入来预测下一个Token,比如输出了“里面”。基础模型就会一直重复这个过程,模拟互联网文档的语言规律。
数学模型示意:
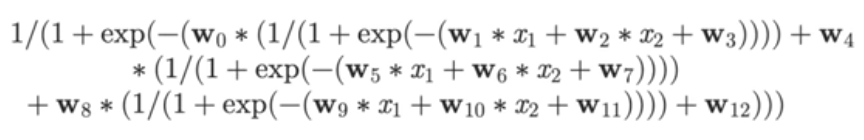
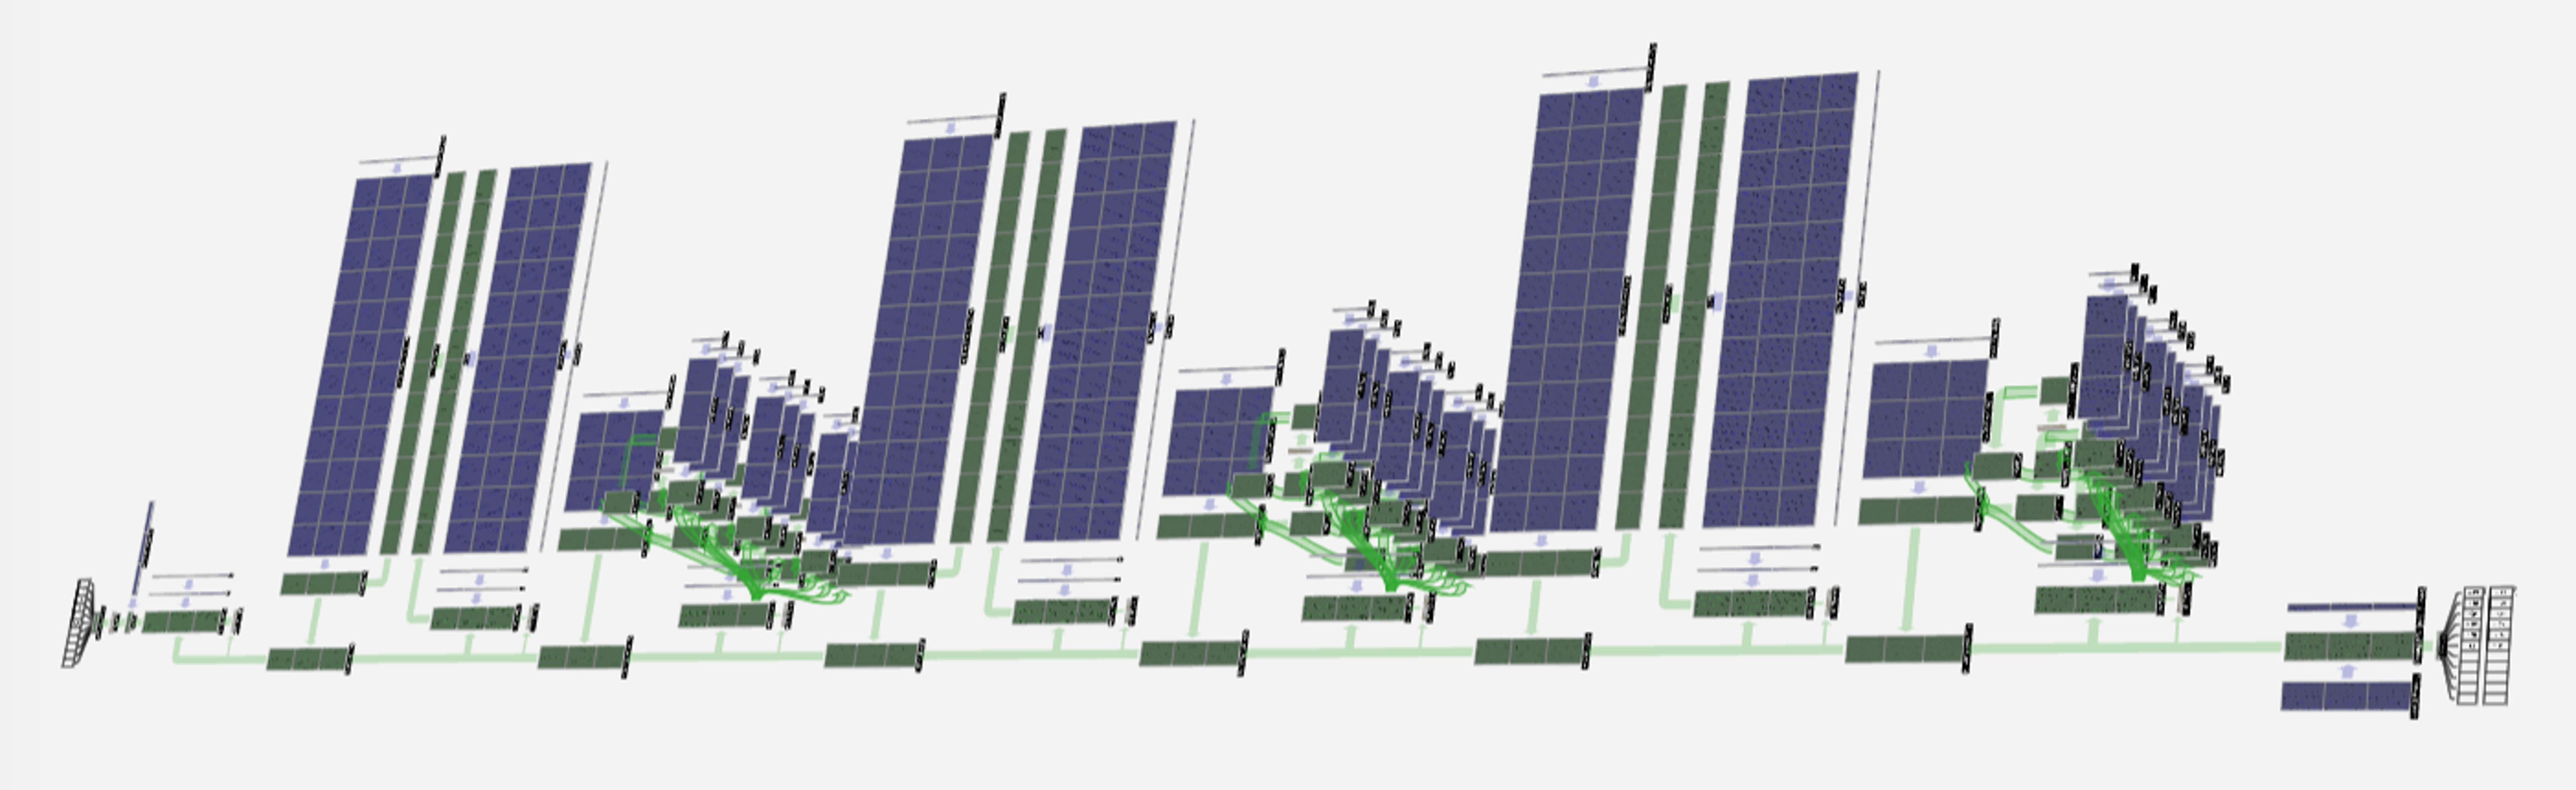
神经网络可视化图,Transformer架构:
回顾
以上就是预训练的三个步骤,我们来一起复习一下。第一步是抓取并处理数据,从互联网上抓取大量数据进行清洗筛选;第二步是Token化,把清洗筛选后的纯文本进行分词,变成适合模型训练的Token ID;第三步是训练神经网络,给模型输入大量Token ID,调整超级复杂的数学函数里面的参数权重,让模型输出越来越接近这个互联网文本的语言规律,得到基础模型。类似于一个有损的zip压缩包,一个互联网文档模拟器。
预训练的局限
但是到目前为止,这个基础模型也还只是会预测下一个Token而已。比如我们问这个基础模型“我明天要去面试,请给我三条准备建议。”,模型回答:“第一,了解公司;第二,准备自我介绍;第三,保持自信。自信是一种重要的心理品质,它和人的成长经历、家庭环境…”。你看,它一开始像是在回答问题,但是很快就顺着“自信”这个词继续预测下一个 Token,结果从“面试建议”写成了“心理学小作文”了。
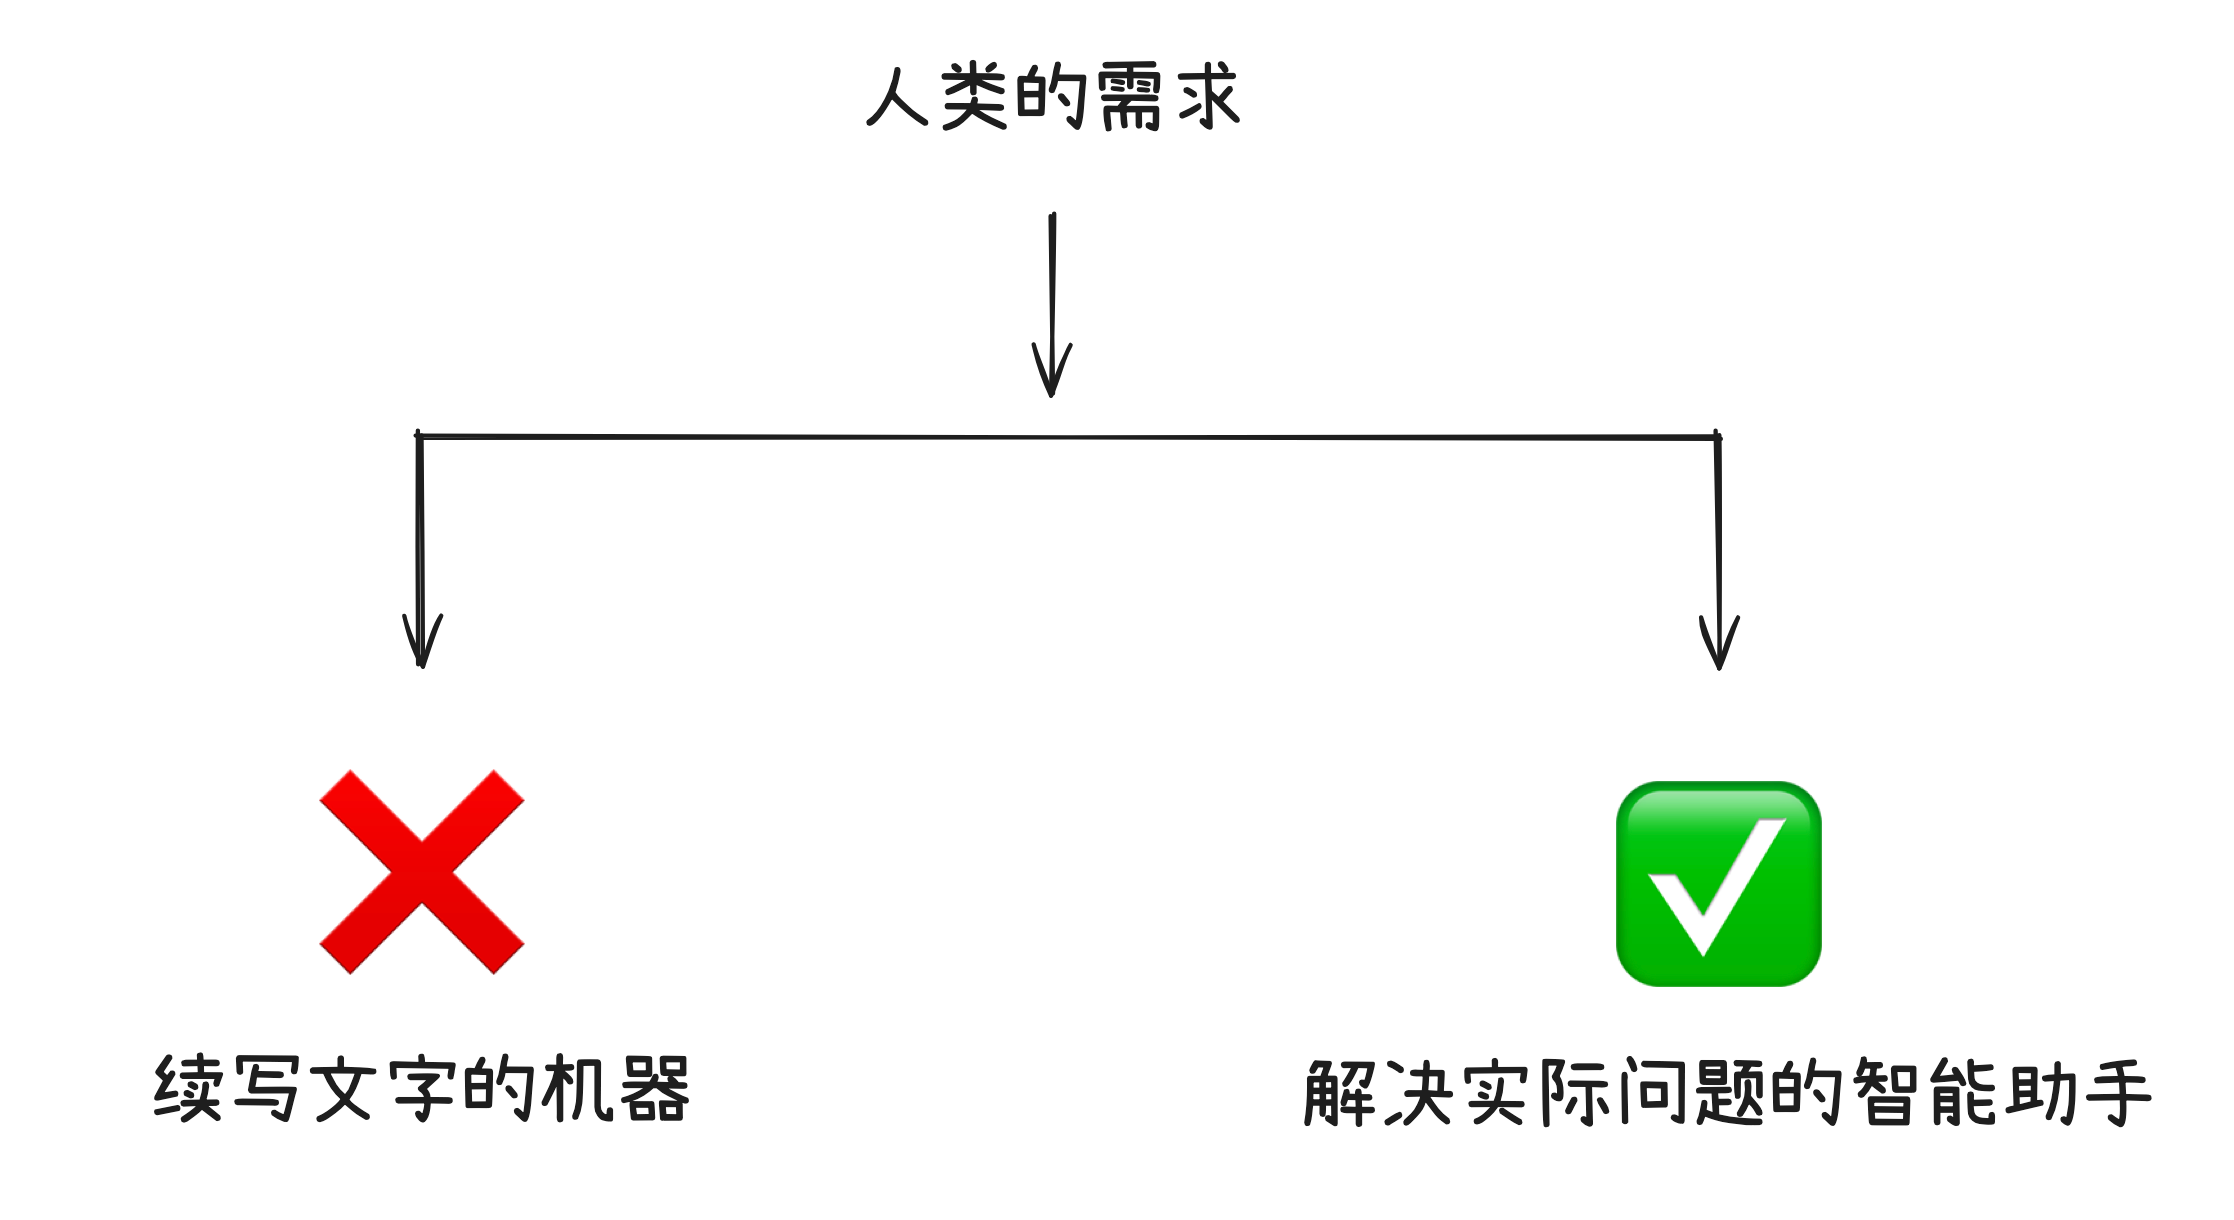
我们要的不是一个续写文字的机器,我们要的是一个能帮我们解决实际问题的智能助手。这时候我们就需要进行后训练了,后训练我会在下一条视频给大家再详细展开介绍。